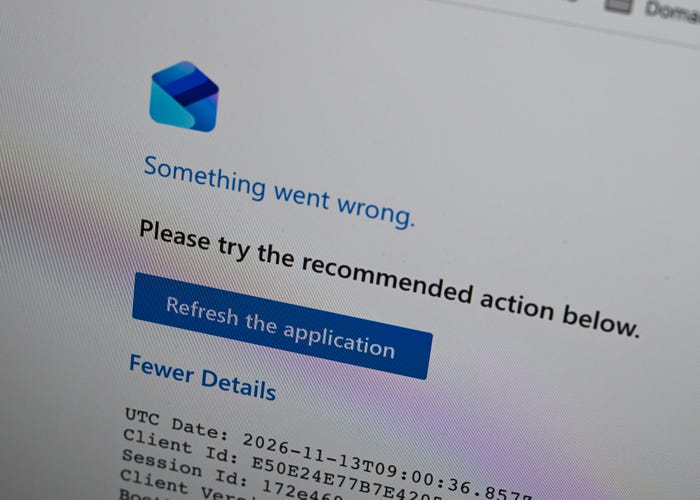
Primele probleme de funcționare au apărut pe 12 noiembrie la serviciul Teams, urmate de întreruperi mai răspândite ale serviciilor Microsoft 365. În mod ideal, propagarea defecțiunii la restul infrastructurii Microsoft trebuia să fie oprită de mecanisme de protecție automate și echipe de mentenanță formate din profesioniști cu experiență. Însă prima linie de apărare a dat greș, perturbarea inițială cauzând un efect în cascadă ce a lăsat milioane de utilizatori fără acces Outlook, Exchange Online, Teams, SharePoint și alte servicii Microsoft 365.
Chiar dacă nu admite în mod direct că întreruperile de săptămâna trecută ar fi fost cauzate de înlocuirea echipelor de programatori și mentenanță cu agenți AI, Microsoft recunoaște că problemele au fost rezultatul unei succesiuni de erori software și probleme de infrastructură nedescoperite la timp, care împreună au provocat prăbușirea în cascadă a serverelor.
Cauza principală pare a fi o eroare software introdusă în iulie, combinată cu alte două probleme de infrastructură apărute săptămâna trecută. Rezultatul a fost că 80% dintre serverele gateway de rețea au încetat să mai răspundă. Serverele încă funcționale au fost imediat copleșite cu volumul uriaș de solicitări, rezultând un blocaj ce nu mai putea fi rezolvat cu ușurință.
Iată explicația oferită de directorul executiv al Microsoft, Charles Lamanna, în rețeaua X:
- O eroare software introdusă în iulie 2026 ca parte a unei remedieri pentru serverele gateway de rețea Microsoft 365. Această eroare a cauzat conflicte de blocare în cadrul unui proces intern, făcând serverele să nu răspundă la anumite sarcini de lucru. Această actualizare defectuoasă a trecut testele regulate Microsoft și a fost implementată la nivel global timp de câteva săptămâni fără probleme.
- Microsoft a descoperit acum că testele sale nu au reușit să identifice eroarea deoarece mediile de testare au folosit în principal hardware mai vechi, mai puțin puternic, cu mai puține nuclee CPU. Cu toate acestea, eroarea era mai probabil să apară pe serverele mai noi, cu un număr mai mare de nuclee.
- Cu câteva ore înainte de această întrerupere masivă, traficul Teams a fost mutat de pe un gateway de rețea alternativ la gateway-ul principal care gestionează și traficul Exchange Online, pentru ca Teams să funcționeze fără probleme. Acesta este un caz normal de failover în designul infrastructurii Microsoft, dar a crescut sarcina și a modificat tiparele de trafic pe gateway-ul de rețea principal al Exchange Online.
- Aproximativ 14% din capacitatea serverului gateway-ului de rețea era deja indisponibilă din cauza unei probleme fără legătură din ziua precedentă. Cu toate acestea, restul de 86% din capacitate era suficient pentru a gestiona sarcini de lucru normale.
- Întreruperea a început atunci când toate cele trei probleme de mai sus s-au combinat. Traficul crescut al Teams, împreună cu capacitatea redusă a serverului, au declanșat eroarea software ascunsă.
- Când astfel de servere devin nefuncționale, infrastructura Microsoft redirecționează automat traficul către servere sănătoase, dar acest mecanism a agravat situația. Serverele au început să cedeze atunci când au început să primească trafic redirecționat major, deoarece sarcina crescută a declanșat aceeași eroare pe serverele respective, creând o eroare în cascadă în întreaga infrastructură Microsoft. În mai puțin de două ore, eroarea s-a răspândit la 80% din flota de gateway-uri de rețea Microsoft.
- Aceste tipuri de defecțiuni sunt în mod normal controlate prin utilizarea unor partiții și regiuni de capacitate separate. Cu toate acestea, o altă problemă a împiedicat aceste măsuri de siguranță să oprească defecțiunea în cascadă, permițându-i să se răspândească la nivel global.
Potrivit companiei, mecanismele obișnuite de recuperare nu au fost concepute pentru a gestiona o defecțiune de o asemenea amploare. Ori de câte ori inginerii au repus online serverele afectate, traficul acumulat le-a copleșit din nou.
Situația a fost și mai mult agravată de faptul că eroarea la partea de software era prezentă încă din luna iulie. Astfel, Microsoft a trebuit să dezvolte o actualizare care să restaureze versiunea anterioară de software pe toate serverele afectate, operațiunea presupunând scoaterea în offline a unor grupuri mari de servere, în vederea reconfigurării. Compania precizează că va publica raportul final post-incident la sfârșitul acestei săptămâni, detaliind inclusiv măsurile care ar trebui să prevină întreruperi similare în viitor.
Autor


