Povestea lui Jensen Huang continuă. Nu o să petrecem prea mult timp pe acest subiect, vreau doar să-l ating în trecere,, dar bă mi se pare tare amuzant. Tot mai apar diferite posibile rapoarte despre alte relații avute de Jensen cu angajate NVIDIA, asta inclusiv după ce și-a dat demisia și nu mai este la conducerea companiei. Dar ce mi se pare și mai interesant este faptul că au apărut petiții să-l aducă înapoi, petiții semnate deja de 100 de mii de oameni și faptul că sunt zvonuri puternice că se ia în considerare să revină ca CEO al NVIDIA. Toate astea în mai puțin de o săptămână. Voi vă dați seama ce nebunie se întââmplă acolo? Gen… ne-ai futut la propriu și la figurat toată compania, literalmente, pleacă naibii de aici… peste 2 zile … a hai că am glumit, nu vrei tu să te întorci? Că pierdem cam mulți bani la bursă. Da încearcă și tu să te ascunzi mai bine de data asta.
Mă rog, nu despre aventurile lui Jensen vorbim astăzi, ci despre un proiect NVIDIA care trebuia să se lanseze acum 1 an de fapt dar au întârziat din naiba știe ce motive. RTX Spark. Știu, am mai discutat de acest chip acum câteva săptămâni când am testat frumosul ProArt P16 al celor de la Asus, dar a venit rândul competiției să-și spună cuvântul, pentru că RTX Spark este integrat de 6 producători, cu mai mulți intrând în dans pe viitor, probabil în funcție de cât de mult RAM pot face rost în perioada care urmează. Momentan avem așa: Asus-ul despre care am vorbit, Microsoft cu al său Surface, Dell, MSI, HP șiii Lenovo cu al său Yoga Pro 9 Gen 11, sau 9N în funcție de regiunea de unde-l cumperi, cod 15N1X11.
Hai să vedem ce putem face diferit acum, după ce am chinuit deja un alt RTX Spark, dar mai ales după ce avem experiența recentă cu DGX Spark, video tot aici pe Zonă.
Tot Buzz-ul, toată nebunia și toate poveștile spuse de NVIDIA cu Jensen în frunte, despre aceste chipuri, alături de DGX Spark, este că vor să „democratizeze” utilizarea AI-ului. O soluție pentru o problemă creată tot de ei, gen. Pentru că marile companii de AI fac mai multe lucruri. În primul rând îți colectează toate datele, date care poate tu voiai să fie secrete, dar în momentul în care ai întrebat un chatbot ceva și ai folosit ca sursă orice informație proprie, secretă sau exclusivă, well.. ea ajunge ba să antreneze respectivul AI, ba naiba știe pe ce site-uri pentru că a fost oferită deja ca răspuns altcuiva. În al doilea rând, de ceva timp avem chatboți lobotomizați pe versiunile free. Sunt castrați și limitați agresiv, tocmai ca să te împingă spre abonamentele lor plătite lunar. Că toată infrastructura asta costă din ce în ce mai mult, mai ales când plătești de 10 ori mai mult pe RAM, după ce l-ai acaparat pe tot.
Asta pe parte de clienți non-business, că la companii unde te taxează la token…e jale. Sistemul e simplu, te ademenesc la început că uite ce util e, după care tu integrezi respectivul AI în obiceiurile tale, începi să depinzi de el, poate chiar se înrădăcinează în app-urile tale prin automatizări șiii bam după câteva luni explodează tarifele.
Companii precum Microsoft aveau concursuri interne care poate folosi cât mai multe tokenuri AI la începuturi, iar după ce Anthropic a crescut prețurile, Microsoft mai să facă infart când o factură sărea de sute de milioane așa că băieții au zis gata, ne întoarcem la Copilot :)) glumesc, nimeni nu folosește copilot, nici măcar Microsoft.
Și în centru e NVIDIA care face bani oricum pentru că e sursa de chipuri și rackuri de servere pentru data centers. Doar că NVIDIA a zis… ce ar fi să vindem și la persoanele nemulțumite de prețurile astea mari la abonamente, la hardware, la utilizare lunară și la cei care sunt îngrijorați cu securitatea și pricvacy. Așa, dragii mei, au apărut Spark-urile. Practic în oricare tabără ai fi… tot hardware NVIDIA folosești.
Design/Construcție
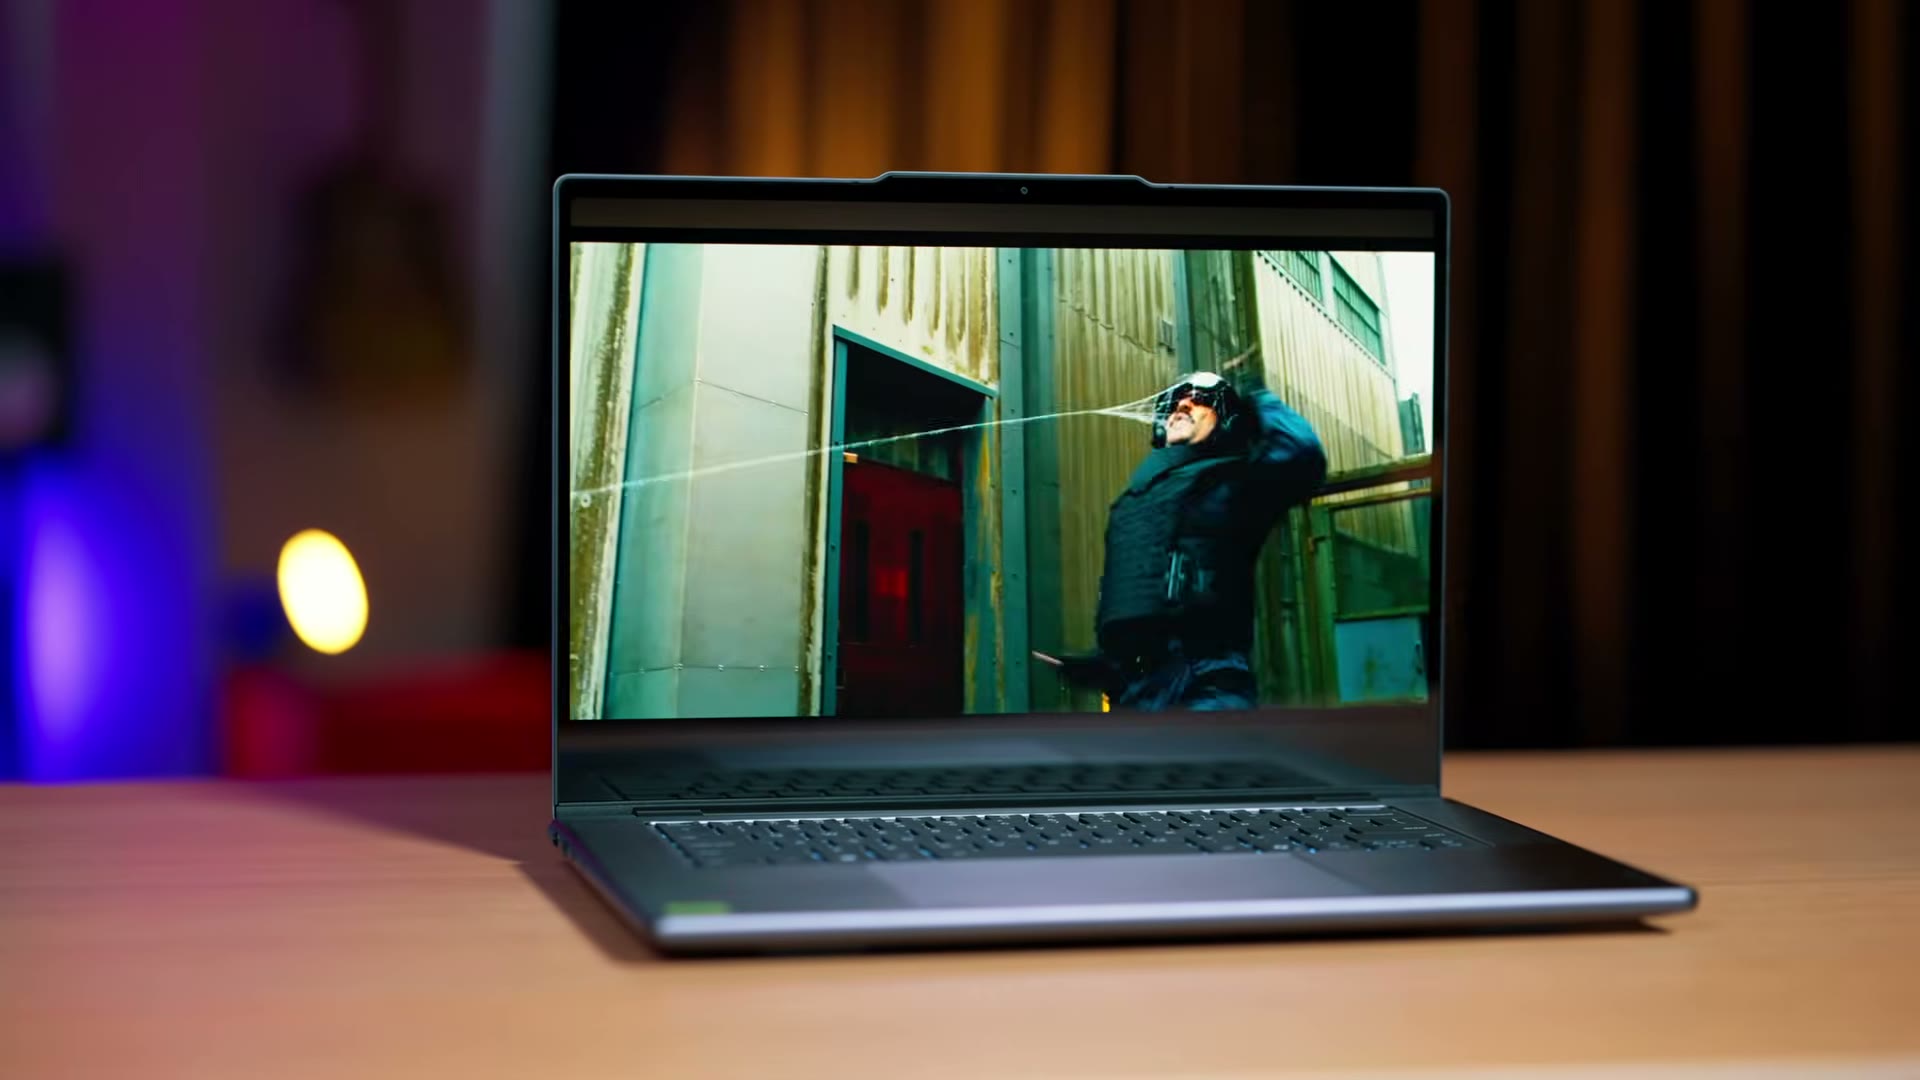
Să începem ușor cu pacientul de astăzi, să nu vă pierdem pe drum. șasiul modelului Lenovo Yoga Pro 9 Gen 11 disponibil doar pe 15 inchi este prelucrat integral din aluminiu anodizat CNC, cu o greutate de aproximativ 1,9 kilograme și o grosime care pornește de la 17,9 milimetri. Finisajul mat rezistă la amprente, iar muchiile ușor rotunjite nu te înțeapă la încheieturi pe parcursul sesiunilor lungi de scriere a acestui review. Capacul superior are un design minimalist, marcat doar de sigla discretă Yoga și de proeminența din partea superioară, care găzduiește camera web IR de 5 megapixeli cu obturator electronic și rețeaua de patru microfoane. Construcția este solidă, iar balamalele sunt suficient de rigide cât să nu permită flex al ecranului, nici când îl deschizi cu un deget fix din colț.
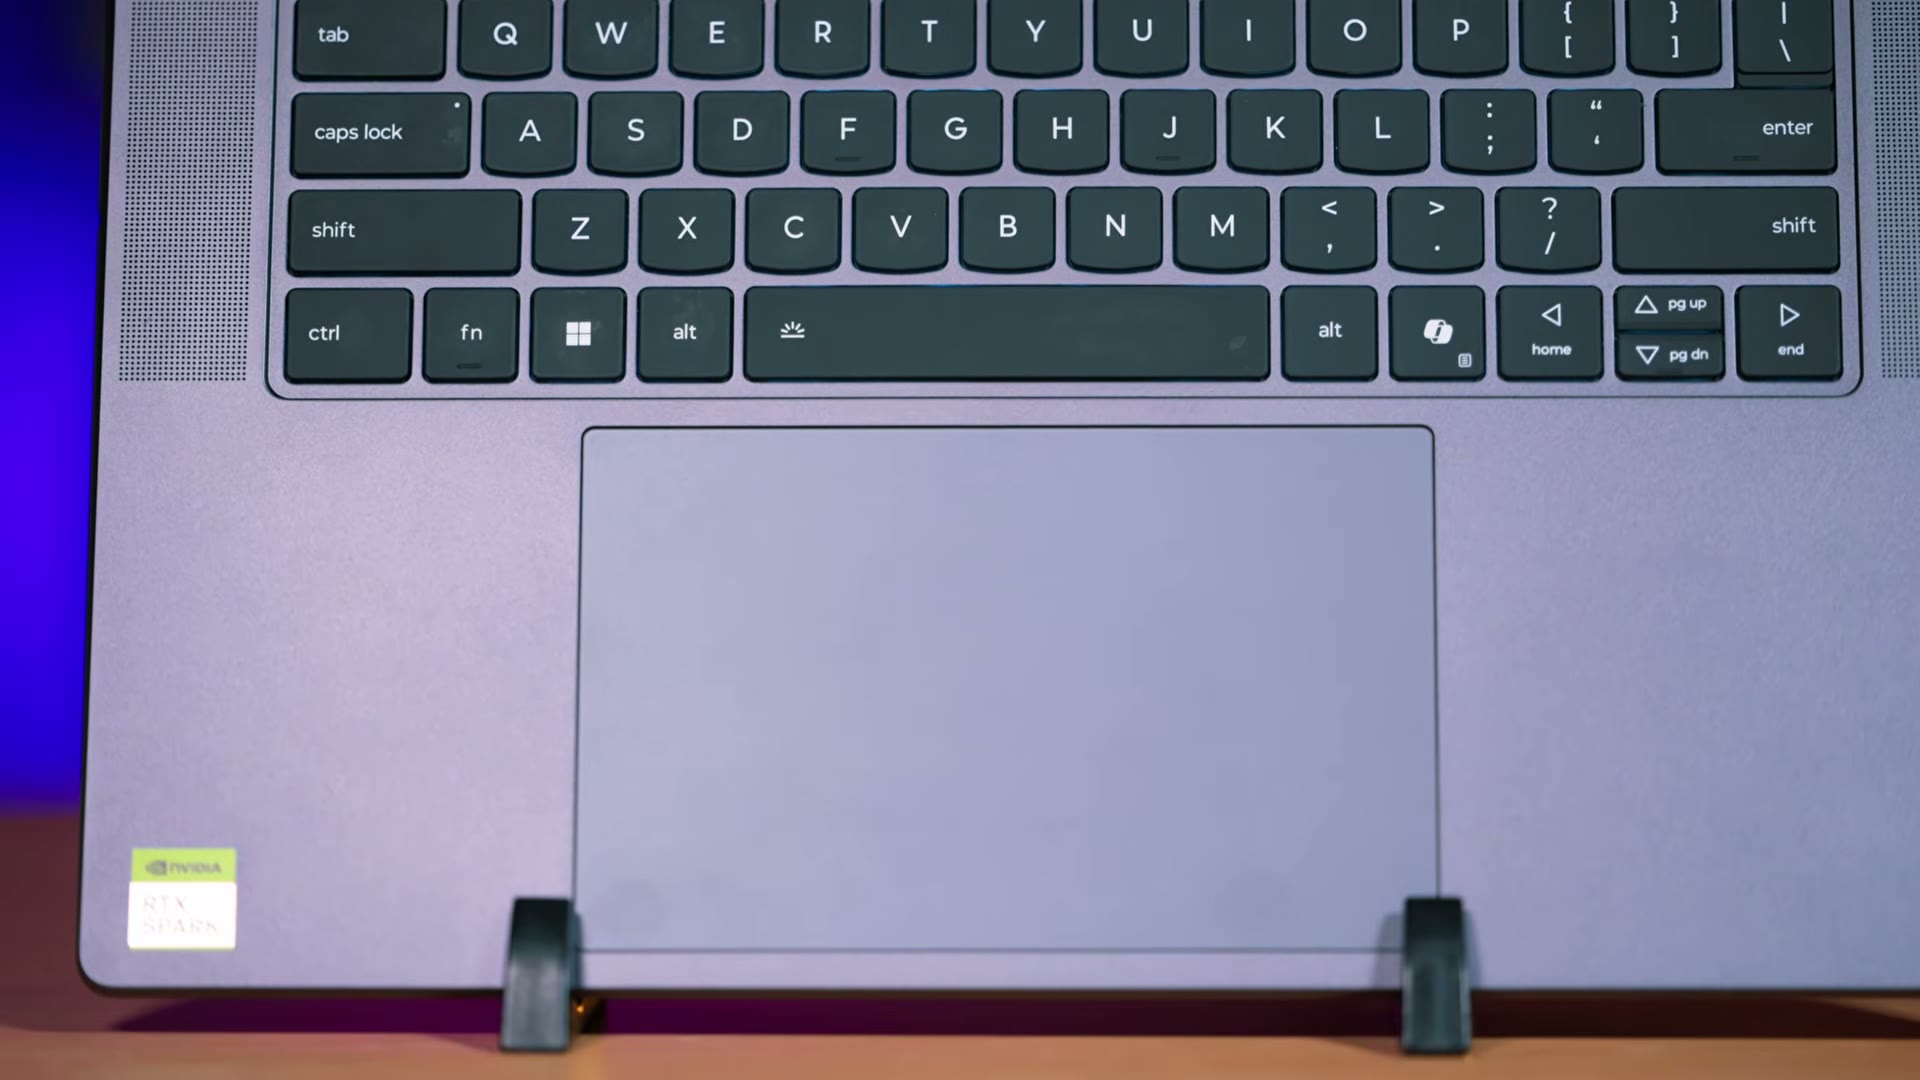
Zona de lucru pune accent pe ergonomie și precizie. Tastatura oferă o cursă de 1,5 milimetri foarte satisfăcătoare în tastat cu iluminare albă pe mai multe niveluri și este flancată de grilele sistemului audio cu șase difuzoare Dolby Atmos. Acesta este format din două tweetere de 2 wați și patru woofere de 2 wați. Sub bara de spațiu se află un touchpad haptic masiv din sticlă mată, cu dimensiuni de 135 pe 80 de milimetri. Se simte excelent, chiar dacă în continuare apelez la mouse pe cât posibil.
Ecranul tactil PureSight Pro de 15,3 inchi este destul de imersiv pentru că are marginile destul de înguste, oferind un raport de peste 91 la sută între suprafața activă și dimensiunea totală a capacului. Panoul utilizează tehnologie Tandem OLED la o rezoluție de 2880 pe 1800 de pixeli în format 16:10, atinge o rată de reîmprospătare variabilă de până la 165 de herți, acoperă 100 la sută din spectrele de culoare sRGB și DCI-P3 și urcă până la o luminozitate de vârf de 1100 de niți în conținut HDR. Ecranul acesta OLED este absolut superb, poți să-l folosești liniștit inclusiv pentru editare foto/video pentru că are un delta E minuscul <0.5, iar luminozitatea de peste 1000 de nits se va traduce în utilizare liniștită și în razele directe ale soarelui, asta dacă vrei să folosești acest Yoga Pro 9 și în „Work From Home” de pe plajă gen.
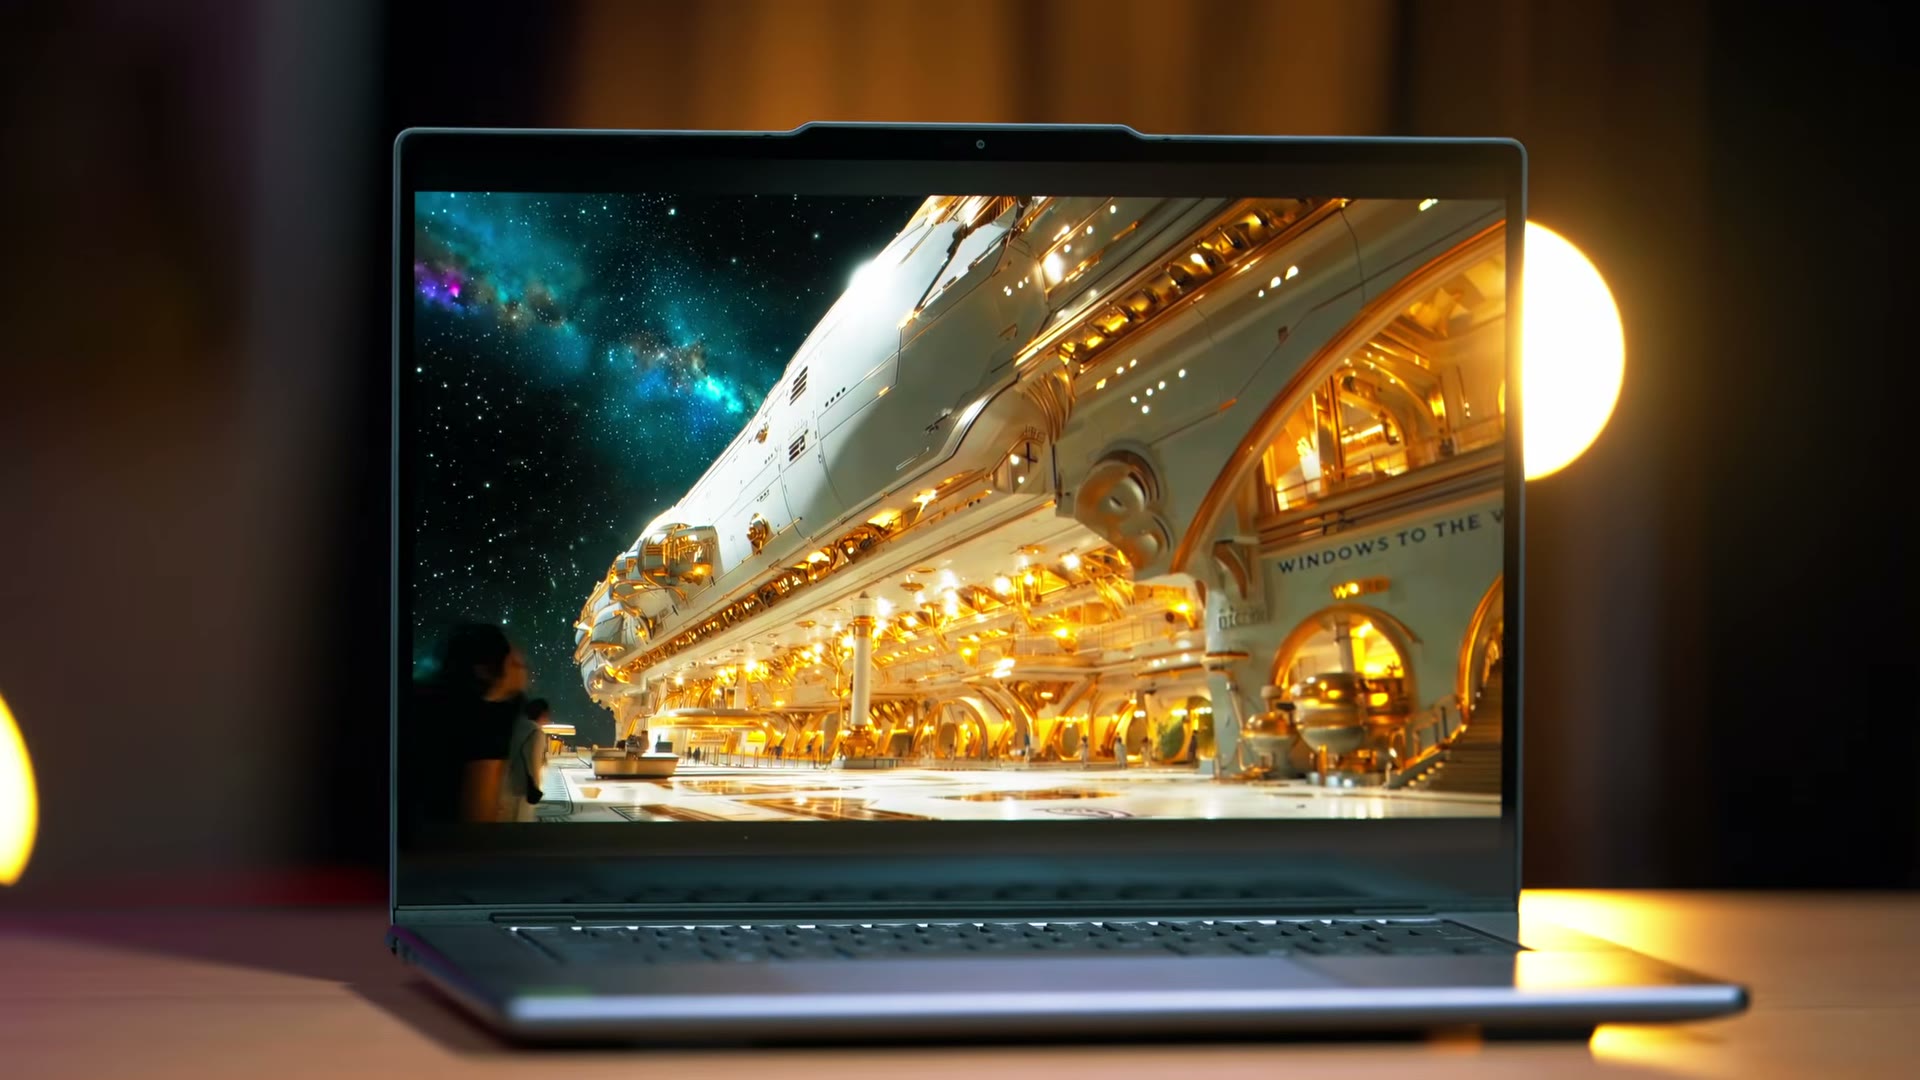
Sticla protectoare acoperă atât ecranul cât și marginile negre, tocmai ca să nu te încurce când te chinuie talentul cu gesturi multi touch de până la 10 puncte. Acum ca o notă personală, că tot văd că se bucură lumea pe Internet că a făcut și Apple în sfârșit un touch screen. Sincer vorbind, nu știu exact cât de multe laptopuri cu touch screen mi-au trecut prin mână, dar sunt multe, nu mă regăsesc folosind acest ecran mai mult de câteva minute să văd cum se simte. În cazul unui laptop nu îi văd sensul. Pur și simplu nu îmi vine natural să întind degetul să dau click când ajung instant cu touchpadul acolo unde vreau pe ecran. Și nu voi avea niciodată precizie calumea cu degetul cum am cu un cursor mic și finuț pe ecran. Nici nu mai zic despre urme, urme care se vâd și mai rău pe sticla asta foarte glossy folosită de Lenovo pentru acest superb panou OLED de altfel. Cred că aș sta non stop cu cârpa de ochelari în buzunar, gata să dau wipe ecranului odată la 2 minute.
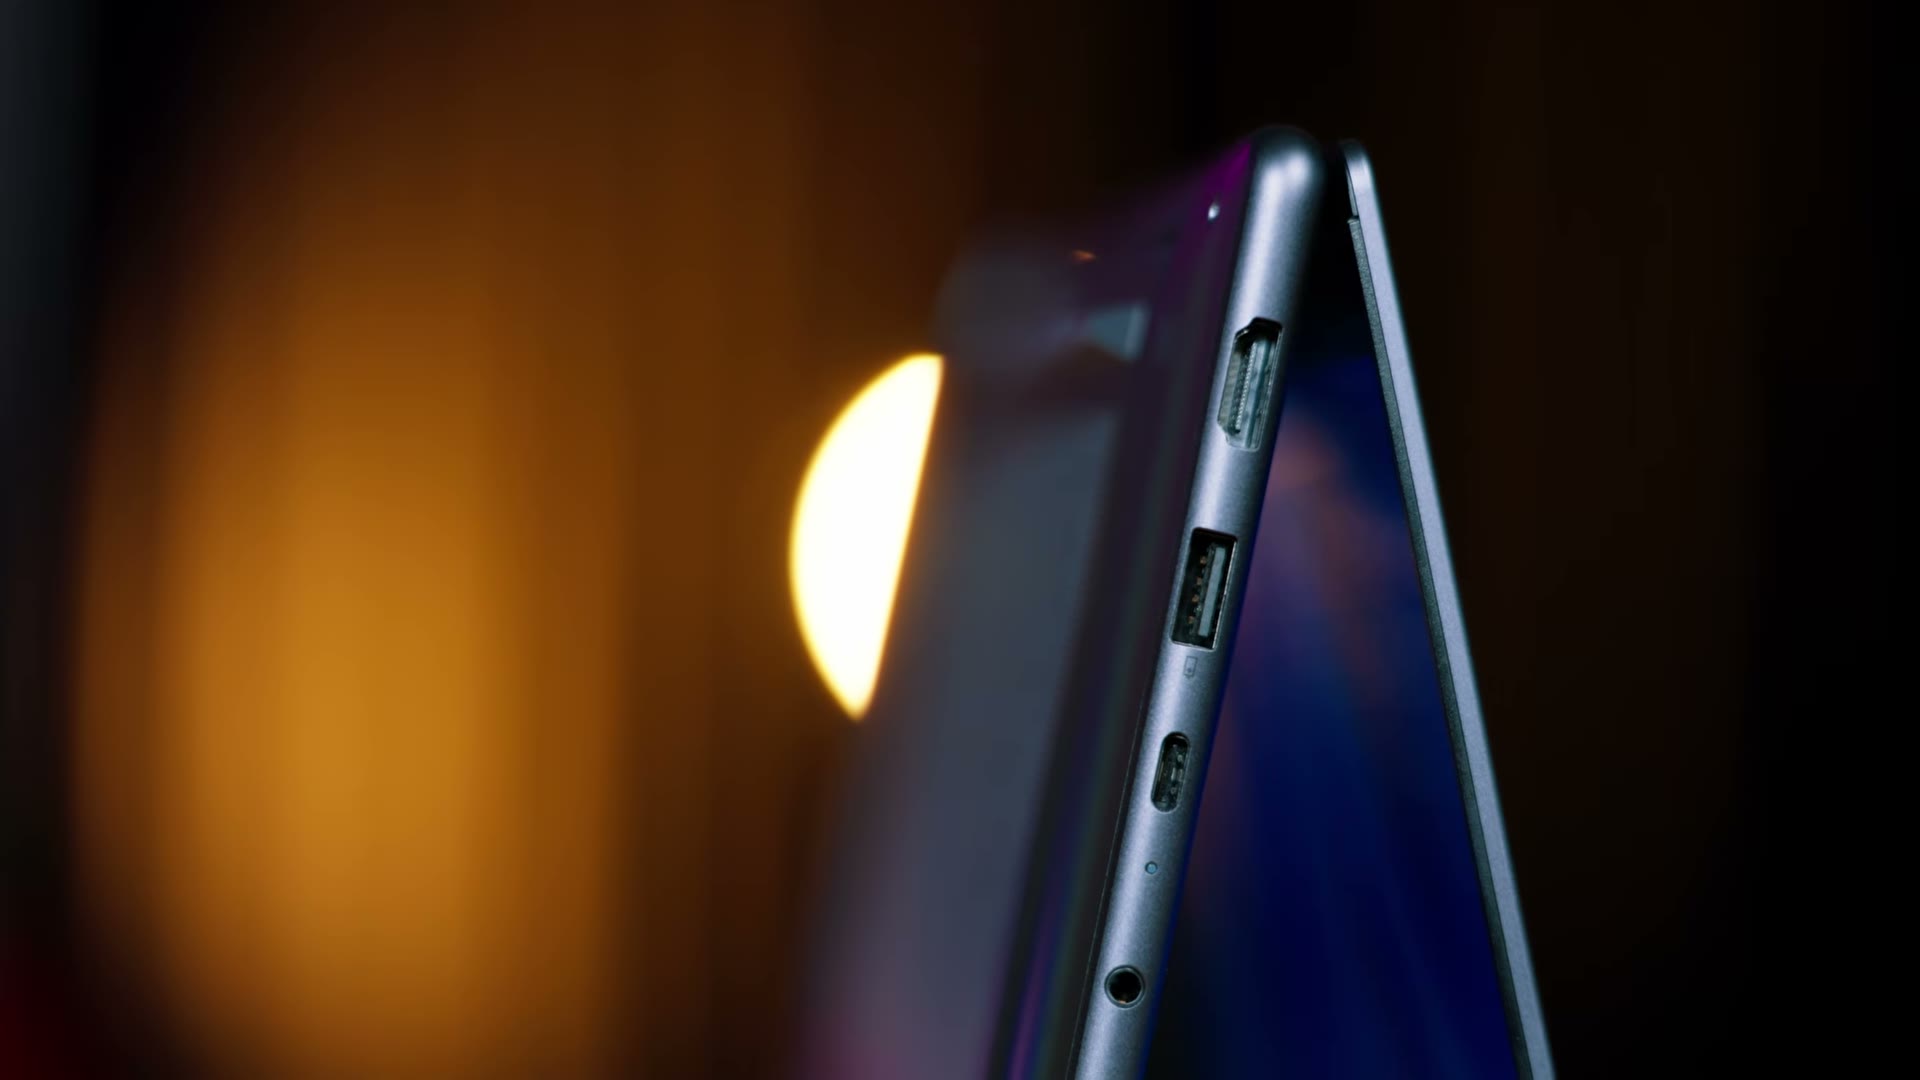
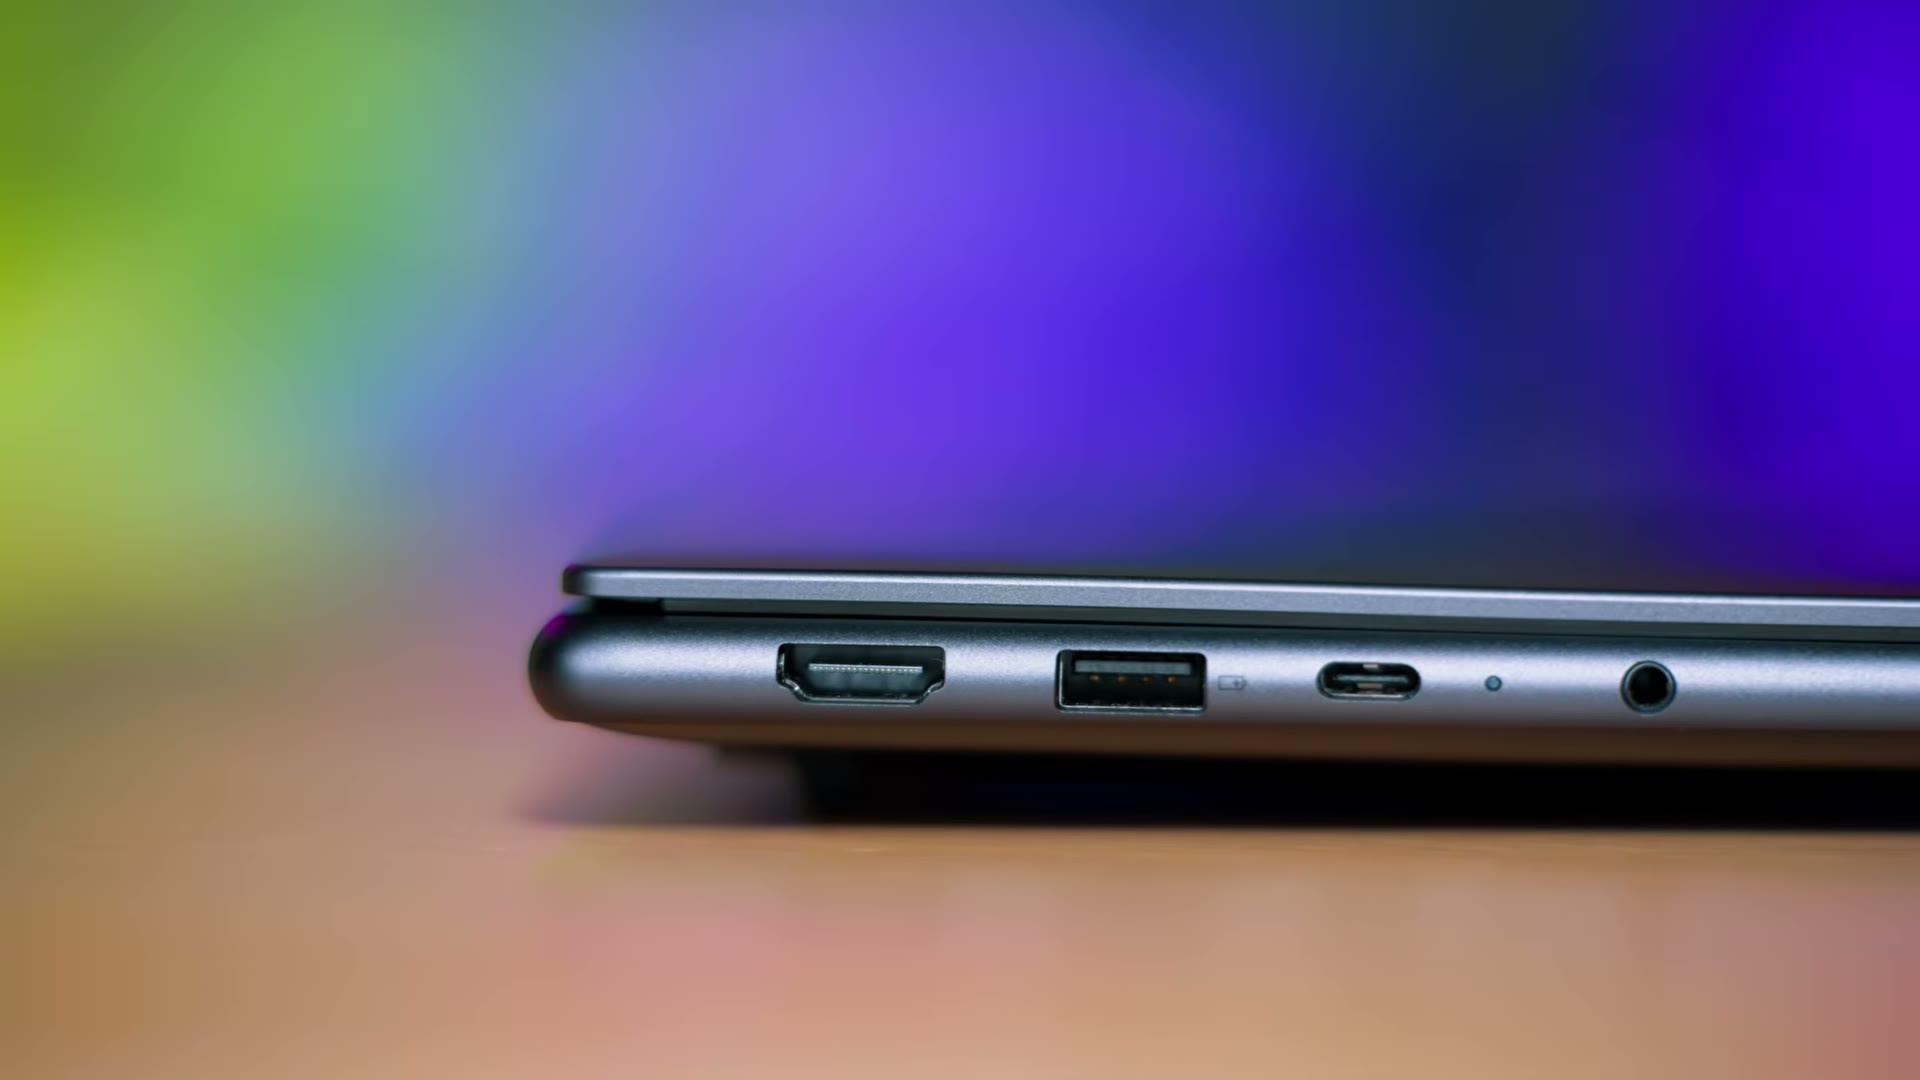
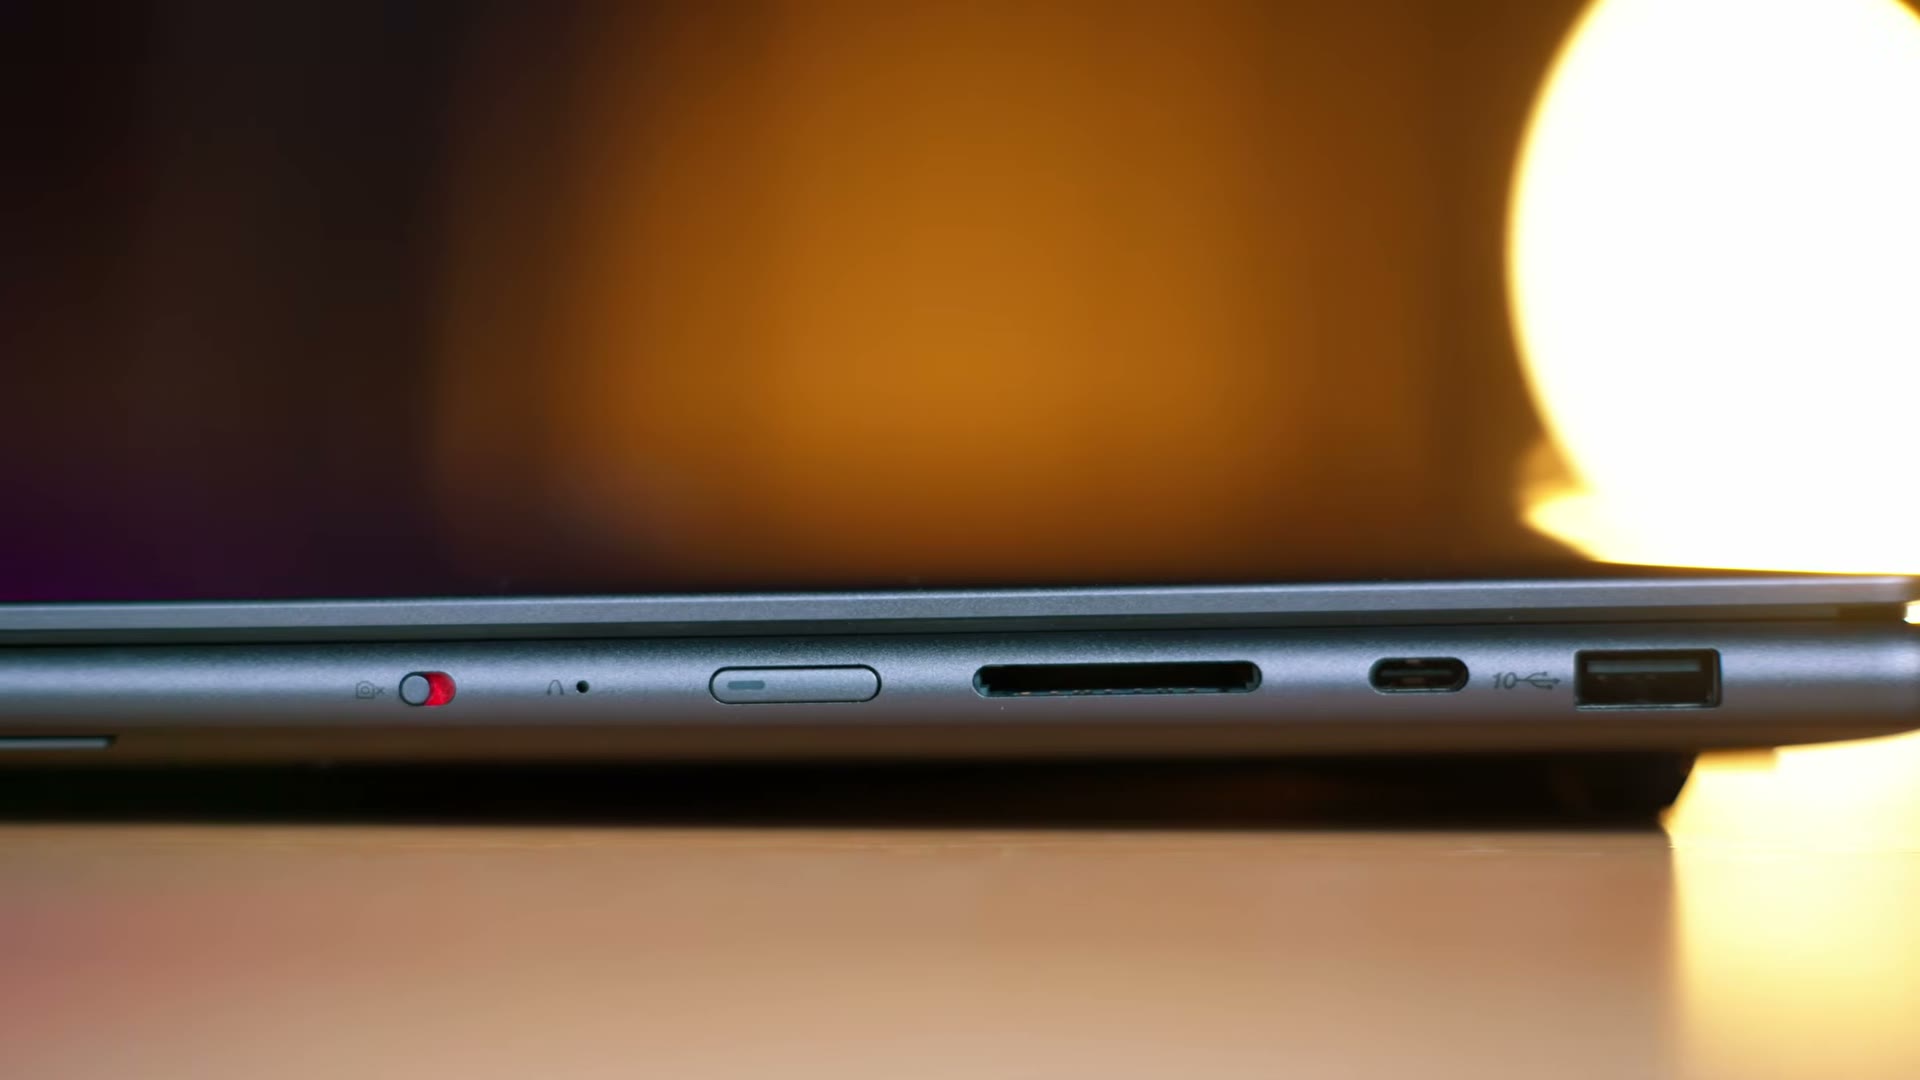
La capitolul conectivitate bifăm următoarele porturi, distribuite egal pe ambele laterale ale laptopului ca să nu fie bătaie. două porturi USB-C cu rată de transfer de 40 Gbps și suport Power Delivery și DisplayPort 2.1, un port USB-A 3.2 Gen 1 la 5 Gbps, o ieșire HDMI 2.1 capabilă de semnal 4K la 120 de herți, un cititor de carduri SD UHS-II și un conector audio combo de 3,5 milimetri. Singurul compromis deranjant este amplasarea butonului de pornire pe marginea laterală dreaptă, o decizie moștenită de la varianta convertibilă 2 în 1 echipată cu aceeași platformă RTX Spark, unde accesul din lateral devine necesar în modul tabletă, dar care pe un laptop clasic crește riscul de apăsare accidentală la ridicarea dispozitivului de pe birou, lucru care mi s-a și întâmplat. Înțeleg economia să faci un singur șasiu pentru amândouă, dar aș fi preferat butonul de power amplasat normal.
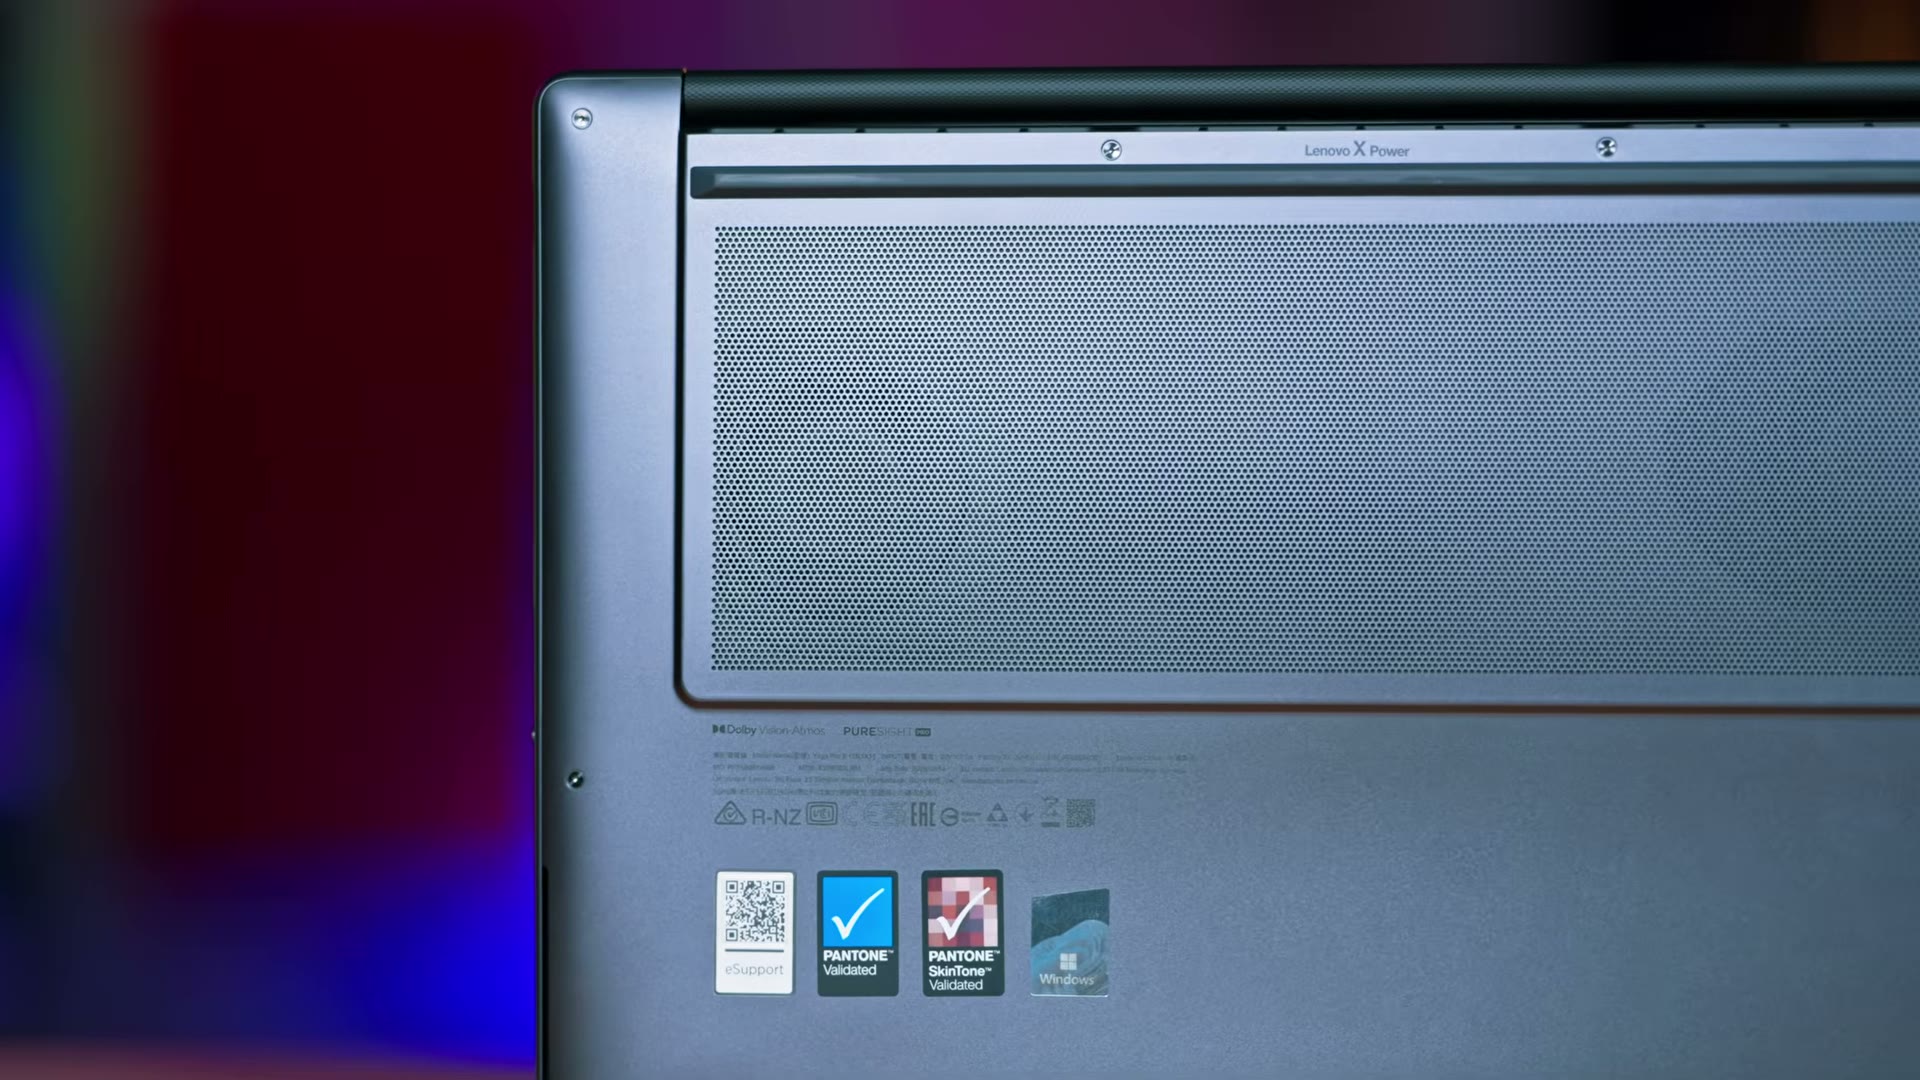
Grilele de intake și evacuare a aerului sunt ascunse sub balama și pe panoul inferior, astfel sistemului de răcire disipă eficient căldura generată de procesorul RTX Spark cei 128 GB LPDDR5X la 9400MT/s.
De ce mai mult RAM e recomandat pe un RTX Spark
Despre chipul N1X v-am mai povestit deja, dacă nu știți, este vorba un SoC, adică system on a chip, creat în parteneriat cu Mediatek, pe 3 nanometri, disponibil în 2 versiuni. Prima, cea mai slabă, are 18 nuclee CPU și 5120 Cuda Cores, versiune care vine cu 24 sau 32GB de RAM și a doua, mai puternică, cu 20 de nuclee CPU și 6144 nuclee CUDA pe care poți opta între 32 și 128GB de memorie unificată LPDDR5X. Cele 2 socketuri, CPU și GPU, sunt practic sudate între ele și comunică rapid prin NVIDIA NVLink-C2C (chip-to-chip). Designul este foarte interesant, dar am ridicat semne de întrebare încă de la primul Spark testat cum că deja Mediatek are procesoare pe 2 nano și acest RTX Spark practic trebuia lansat acum un an, mai ales că va avea un ciclu mai lung de existență până e înlocuit de noua versiune.
Există câteva avantaje pentru modelul RTX Spark care dispune de 128GB memorie unificată, avantaje pe care le-am simțit abia după ce am terminat review-ul nostru pentru versiunea de 64GB și a ajuns la birou cel de 128. Cumva trebuia să trecem prin 64 ca să-i știm limitările. Nici nu vreau să mă gândesc cât de mai rău este cu Sparkul de 24GB sau cel de 32GB, asta în condițiile în care trebuie să rulezi și un Windows în același RAM. Știu ce ziceți acum, da, costă cât un rinichi! Și mie mi-e ciudat să recomand ceva exorbitant de scump, dar are avantaje reale.
- Bugetul real disponibil pentru AI – Imaginează-ți că vrei să testezi local un model mare de limbaj pentru a genera structura unui eseu video complex despre istoria studiourilor de jocuri, fără să depinzi de cloud. Asta ca idee, dacă tot iese zilele astea un video despre istoria studio-ului Rockstar pe PlayGround. Pe versiunea de 64GB, după ce Windows, driverele și browserul își acaparează RAM-ul lor, rămâi în cel mai bun caz cu aproximativ 45GB liberi. Dacă încerci să încarci un model de 70 Miliarde de parametri la o calitate decentă (Quantizare pe 4 biți), memoria se umple instantaneu și sistemul începe să facă „swap” pe SSD. Ce înseamnă asta? Înseamnă că totul va rula considerabil mai greu, generarea textului va deveni un chin de 1-2 cuvinte pe secundă. Pe varianta de 128GB, ai peste 100GB de memorie unificată curată la dispoziția GPU-ului, ceea ce înseamnă că poți încărca un model de 70B–120B (cum ar fi Qwen3.5-122B-A10B sau gpt-oss-120b sau ce am folosit noi în perioada testării, Qwen 3.8 Flash Next pe 125 miliarde parametri și q4) complet în memoria RAM rapidă, obținând răspunsuri fluente, instantanee și la o calitate apropiată de modelele frontier de top.
- Fereastra de context (Context Window) și analiza documentelor masive. Să presupunem că pregătești un review detaliat pentru o placă video, dacă mai vedem vreodată o placă video nouă…. sau un socket nou de procesor și arunci în fereastra de chat a modelului local 15 whitepaper-uri tehnice, manualul de reviewer de 200 de pagini și tabelele cu benchmark-uri făcute de tine pentru ultimele trei generații. Aceste date ocupă zeci de mii de tokeni, iar memoria necesară pentru a le ține „active” (KV cache) crește exponențial. Pe modelul de 64GB, va trebui fie să tai din documente, fie să folosești un model mult mai mic și mai slab pregătit pentru a face loc acestor date în memorie. Cu 128GB, ai suficient spațiu încât să ții simultan atât un model mare și inteligent, fix acest Qwen 3.8 Flash Next de care ziceam adineauri, cât și un context uriaș de peste 100.000 de tokeni. Acest lucru permite AI-ului să coreleze o notă de subsol de la pagina 12 cu un grafic de la pagina 180 fără să „uite” începutul documentului. Sau să verifice exemplele furnizate de producător ca valori de bază cu ce ne-au dat nouă toate testele. Și știu ce ziceți, în mod normal nu ne interesează exemplele de rezultate date de producător, dar ni s-a întâmplat prea des în cazul plăcilor video primite înainte de lansare să avem rezultate ciudate rău tocmai pentru că driverele beta dau chix. Și dacă nu știi că ar trebui să scoți de exemplu 10 mii de puncte în Nomadul de Oțel poți lua de bun un rezultat stricat de drivere, rezultat care-ți poate schimba review-ul. Deci un AI care verifică rezultatele tale cu cele din ghid ar fi chiar util.
- Multitasking! Gândește-te la un scenariu de seară, înainte de un deadline: ai deschis un proiect în DaVinci Resolve 4K 10-bit, corecție de culoare și un efect de Noise Reduction, care consumă singur vreo 20–24GB de VRAM. În paralel, vrei să folosești un model local pentru a rescrie o tranziție din voice-over și un alt model vizual (VLM) care să caute un anumit cadru de B-roll prin folderele cu filmări brute. Pe versiunea de 64GB, ești forțat să închizi Resolve-ul de fiecare dată când pornești AI-ul (sau invers), pentru că umplii RAM-ul și dacă AI-ul trece pe SSD o să stai 4 ani juma după rezultat. Versiunea de 128GB taie din această fricțiune: poți ține proiectul video încărcat în memorie, modelul de limbaj pregătit în fundal și scriptul de sortare vizuală activ, trecând de la unul la altul cu un minim timp de așteptare. Acum e imposibil să nu scadă din performanță. trebuie să fim conștienți, aici discutăm de lucruri încărcate în RAM, dar puterea de procesare este la fel de finită.
- Longevitatea, future proofing. Pe platformele moderne cu memorie unificată, cum este cazul SoC-urilor RTX Spark, chipurile de memorie sunt integrate direct lângă procesor pentru a atinge lățimi de bandă considerabil mai mari, ceea ce înseamnă că nu vei putea desface capacul laptopului peste doi ani ca să mai adaugi o plăcuță de RAM. Dacă astăzi un model multimodal capabil să asculte audio, să analizeze video și să genereze text simultan ocupă lejer 40-50GB, nu știi ce se va întâmpla peste 2 ani. NVIDIA ne asigură în prezentările private făcute înainte de lansarea Sparkului că de fapt modelele sunt din ce în ce mai accesibile din punct de vedere al consumului de RAM, dar experiența noastră, cel puțin până acum, este că în general modelele AI sunt considerabil mai capabile cu cât urcă în numărul de parametri și de Tokeni pentru context. Astfel dacă alegi din start varianta de 128GB, te asiguri că laptopul rămâne o unealtă de producție și testare pe toată durata lui de viață, fără să devină limitat de capacitatea memoriei înainte ca puterea de calcul a chipului să fie depășită total.
O testare rapidă
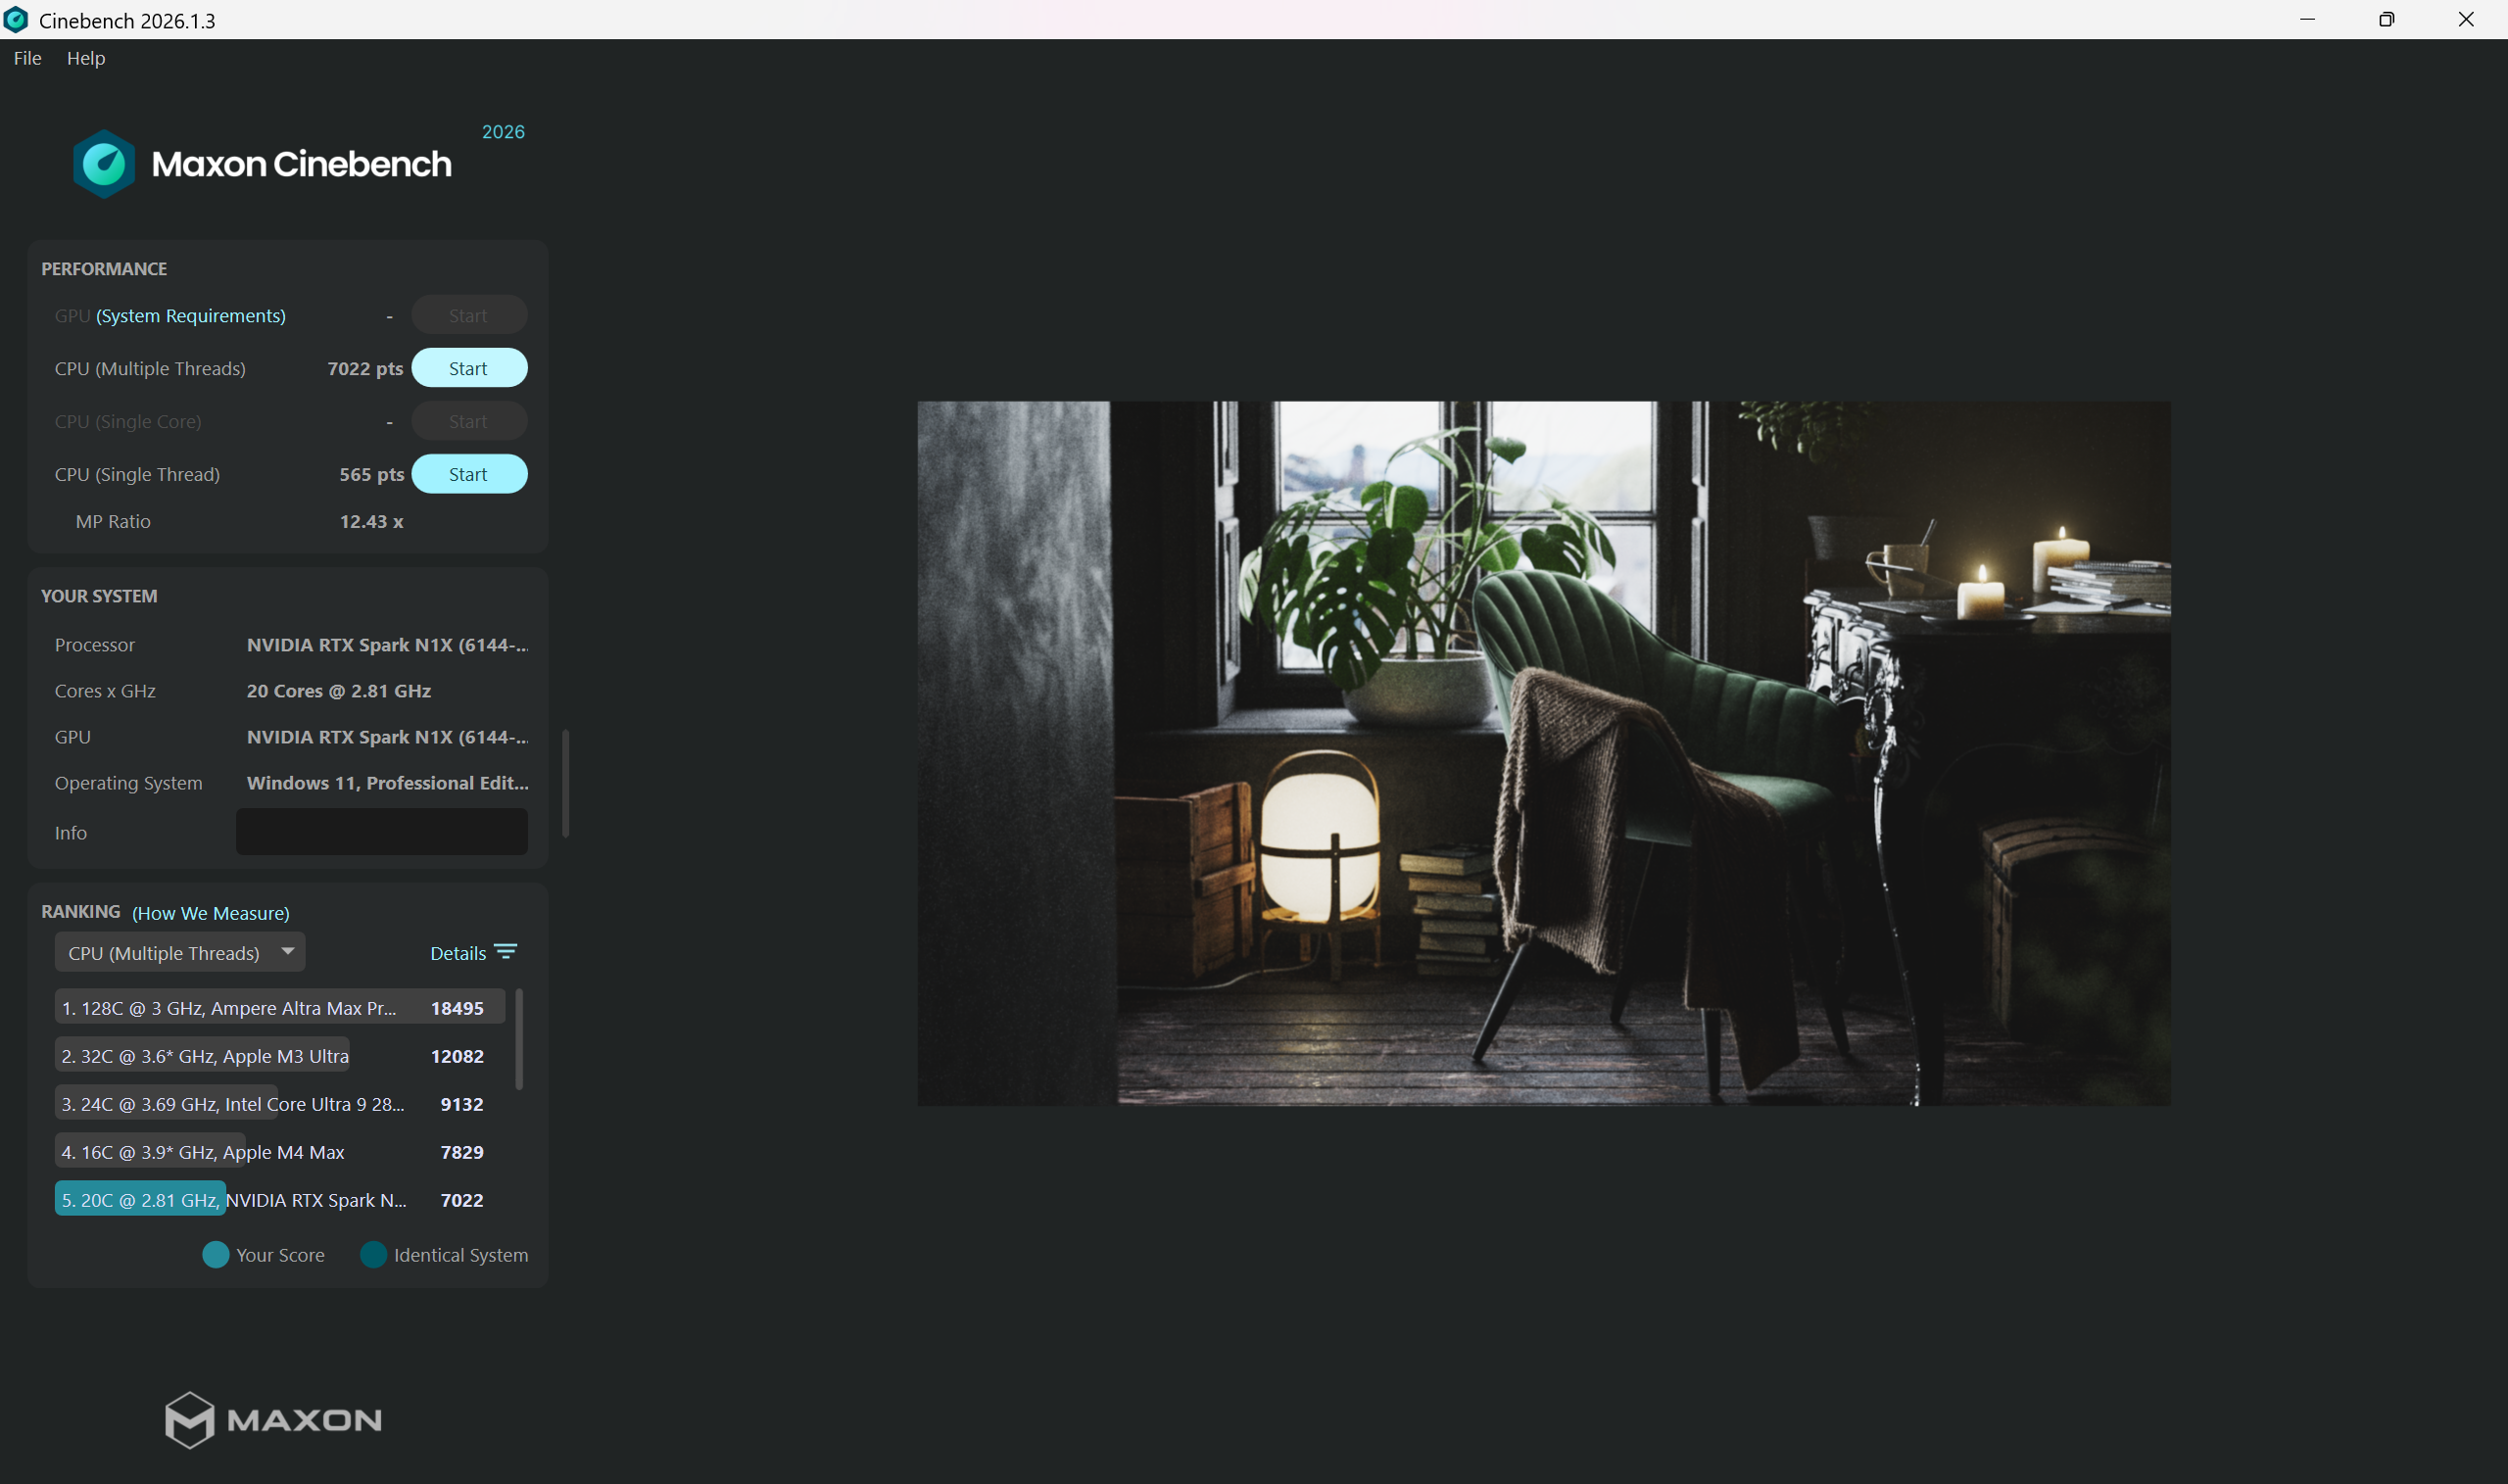
Să-i dăm o cheie rapidă lui Cinebench 2026, așa de verificare doar, că ne mănâncă să vedem unde se situează Yoga Pro versus ProArt-ul celor de la Asus. Scorurile obținute sunt de 7020 puncte în Multi Core cu 560 pe Single Core, față de 7200 de puncte obținute de ProArt. Diferențele sunt mici, dar cel puțin momentan, răcirea fiind diferențiatorul.
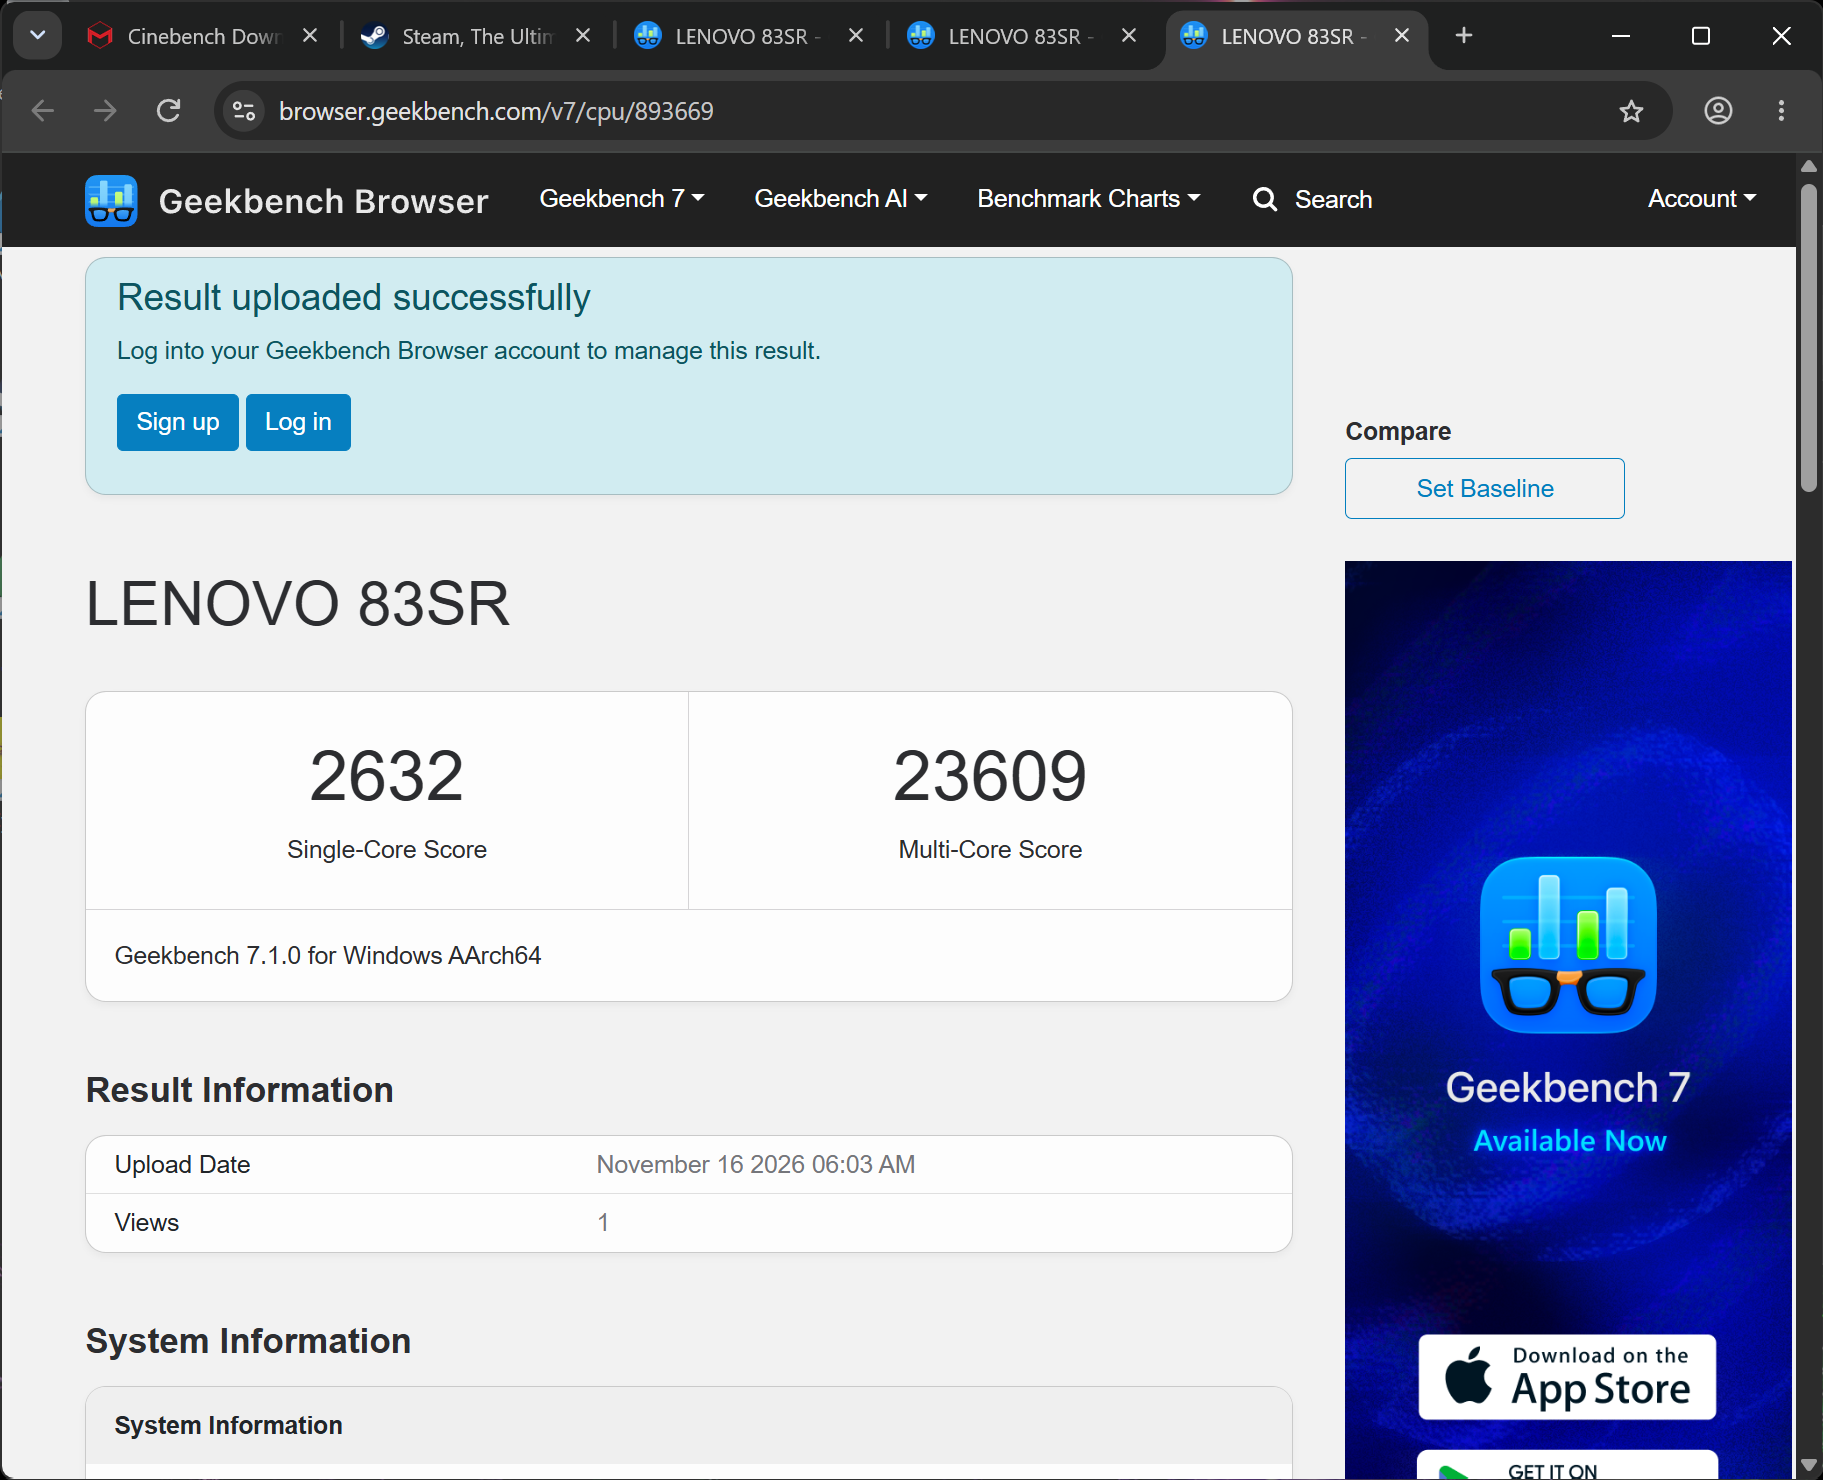
GeekBench 7 a scos scoruri similare, aici am atins chiar 23600 puncte pe Multi Core și 2632 pe Single, comparat cu 23403 Multi Core și 2640 pe Single Core în cazul Sparkului Asus. Și aici putem include și M5 Pro care rupe nori cu peste 29.000 de puncte in multicore si aprope 3700 pe un singur nucleu.
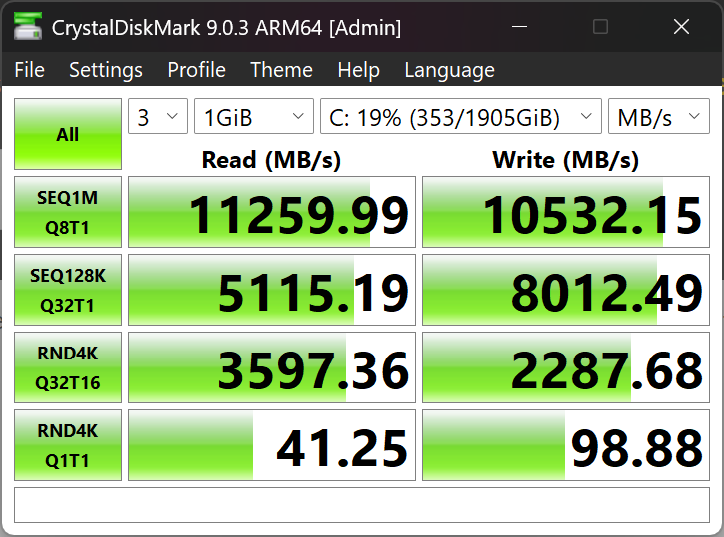
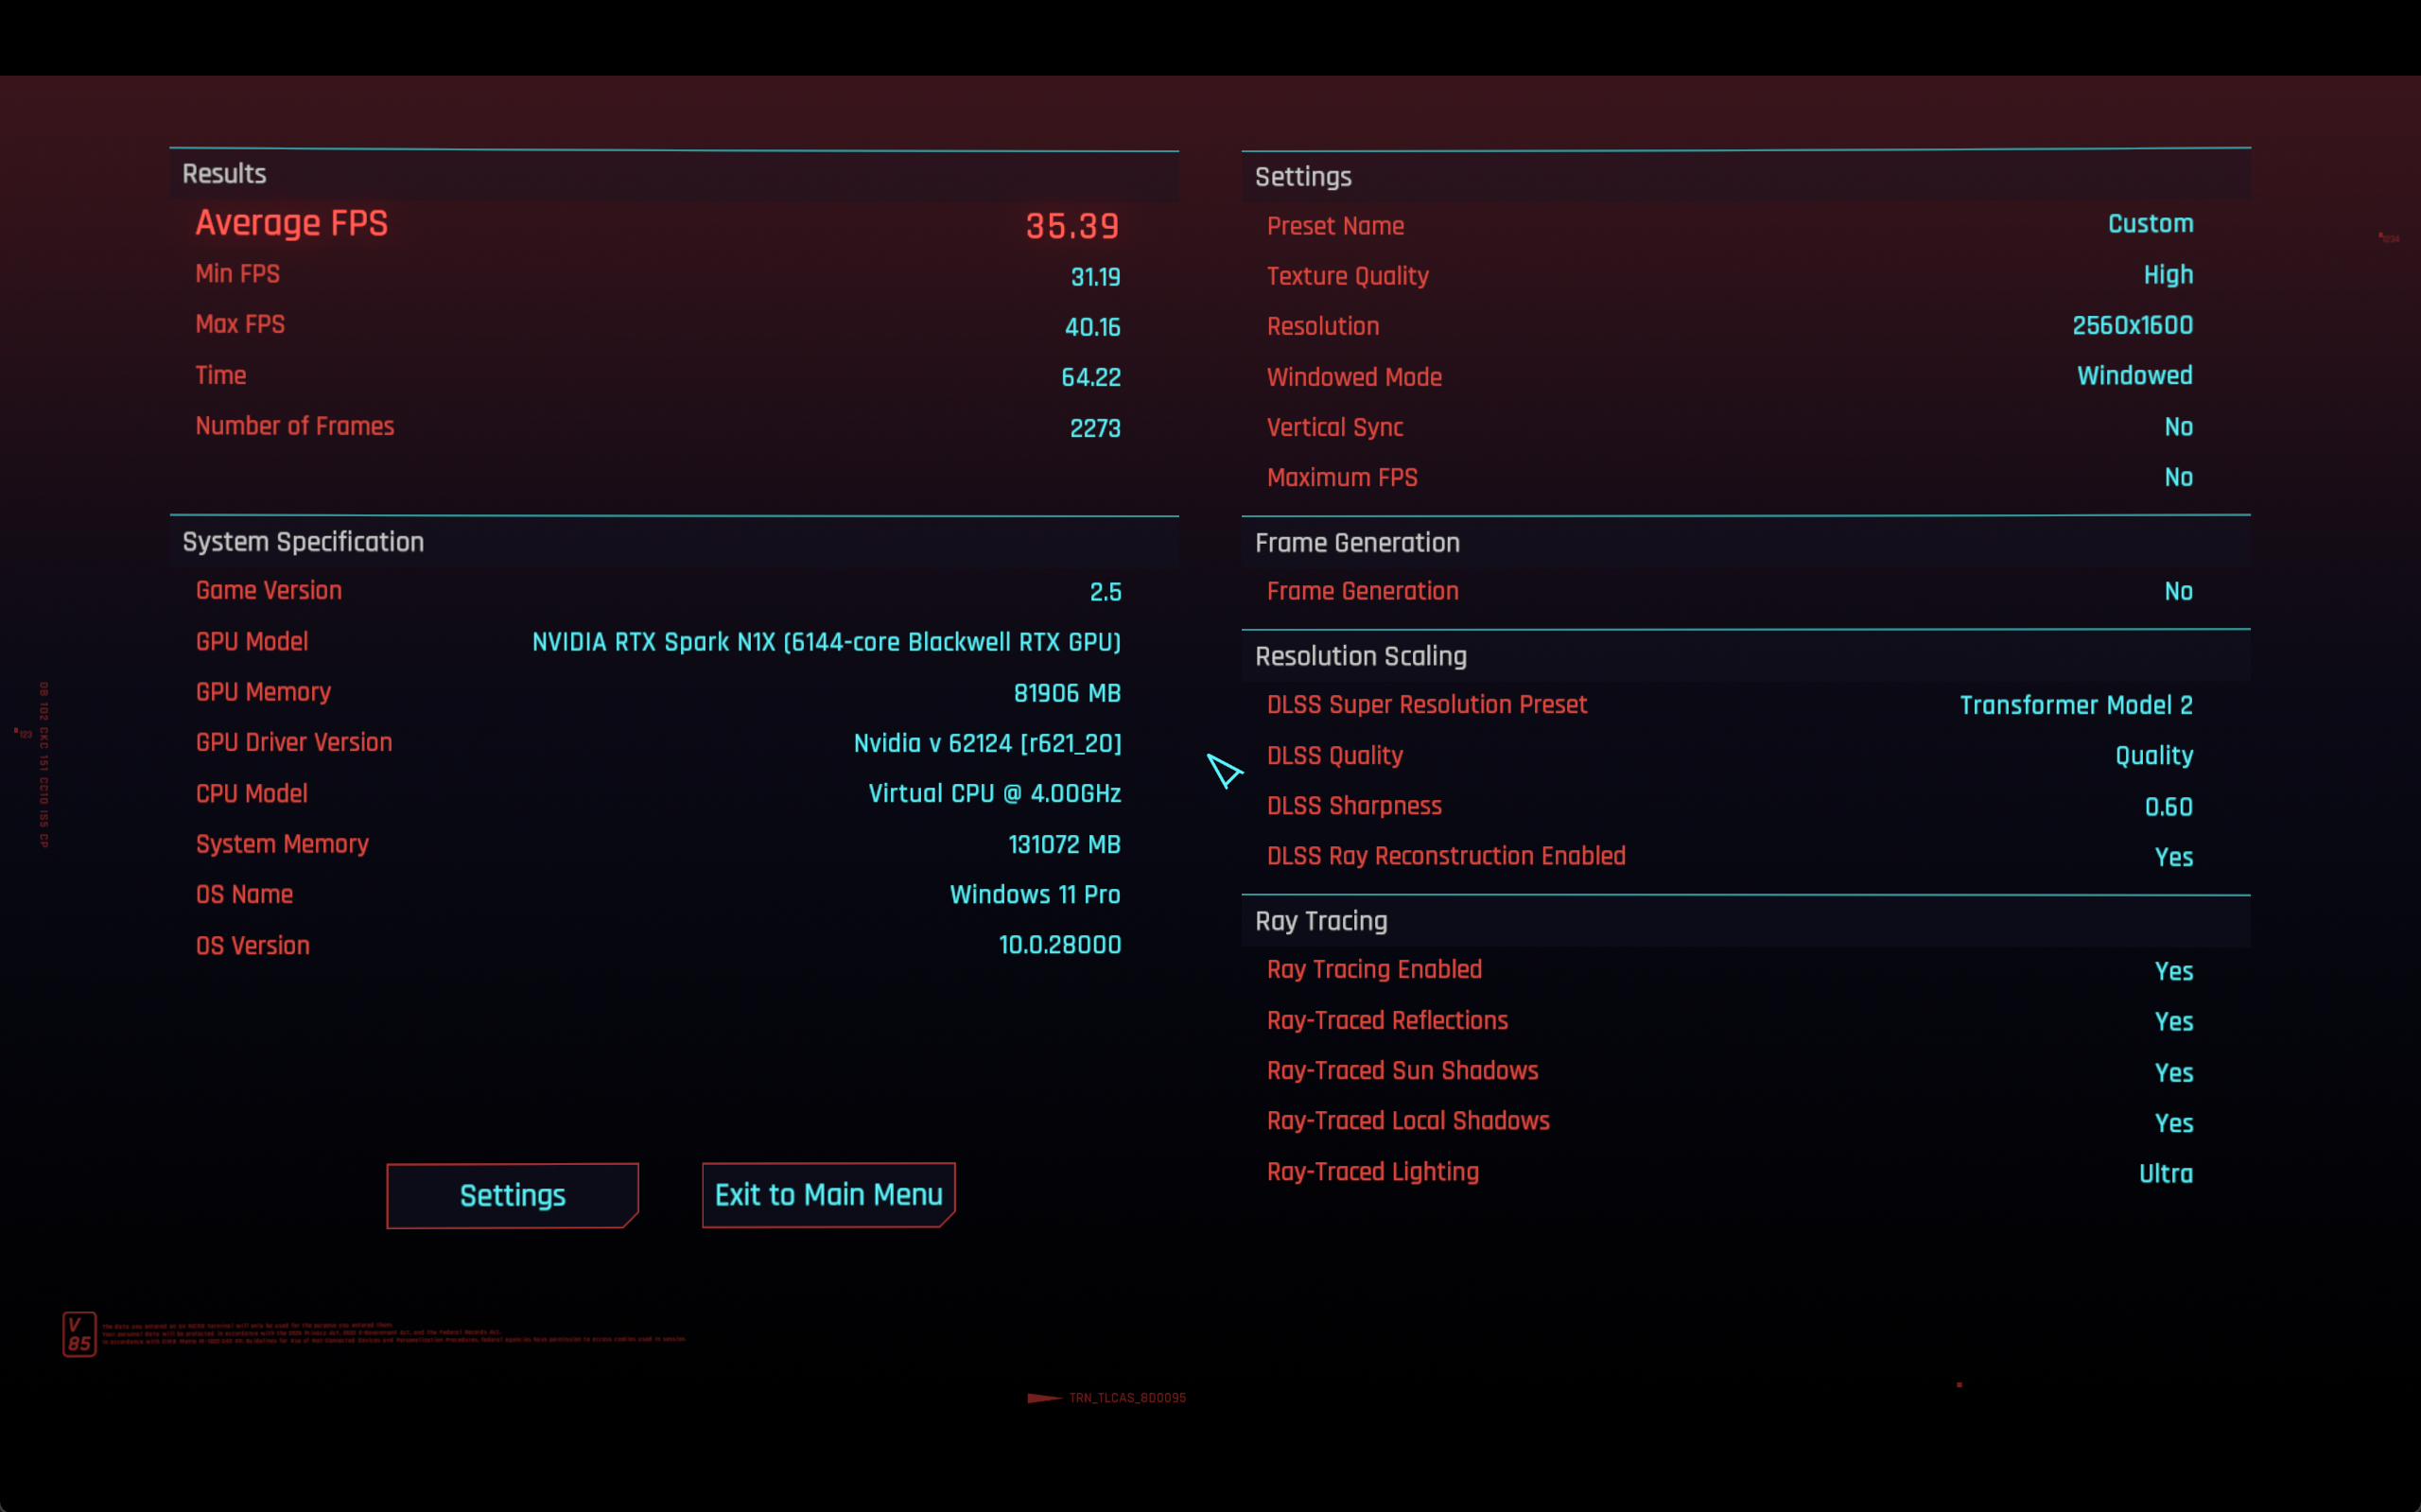
În continuare obținem aceleași valori, sau aproximativ aceleași cu mici variațiuni care apar oricum în benchmarkuri, în Cyberpunk 2077 testat și pe baterie și alimentat la priză. Deci la 2560 x 1600, pe presetul Ray Tracing Ultra scoatem în continuare 35FPS cu ajutorul DLSS-ului pe Quality sau 110-115 FPS cu ajutorul MFG setat pe 4x.
Valorificăm niște AI, de data aceasta Agentic
Bun, dar ce am făcut mai exact diferit de data aceasta, că nu o să vă plictisesc cu toate testele re-rulate pe ce este practic același procesor, dar îmbrăcat în haine diferite. Și nici iar cu aceiași generare de imagini și de clipuri cu LTX 2.5, chiar dacă recent i-au introdus upscaling și frame generation cu ajutorul DLSS-ului și poți face clipuri considerabil mai rapid la o calitate și mai mare. Știm că poate face asta, acel 1 PetaFlop de putere de compute strălucește aici, iar ComfyUI va merge și mai bine pe o cantitate dublă de memorie unificată decât a mers înainte.
Nu, acum că am avut mai mult timp alături de Sparkuri ne vom axa pe partea agentică a lui.
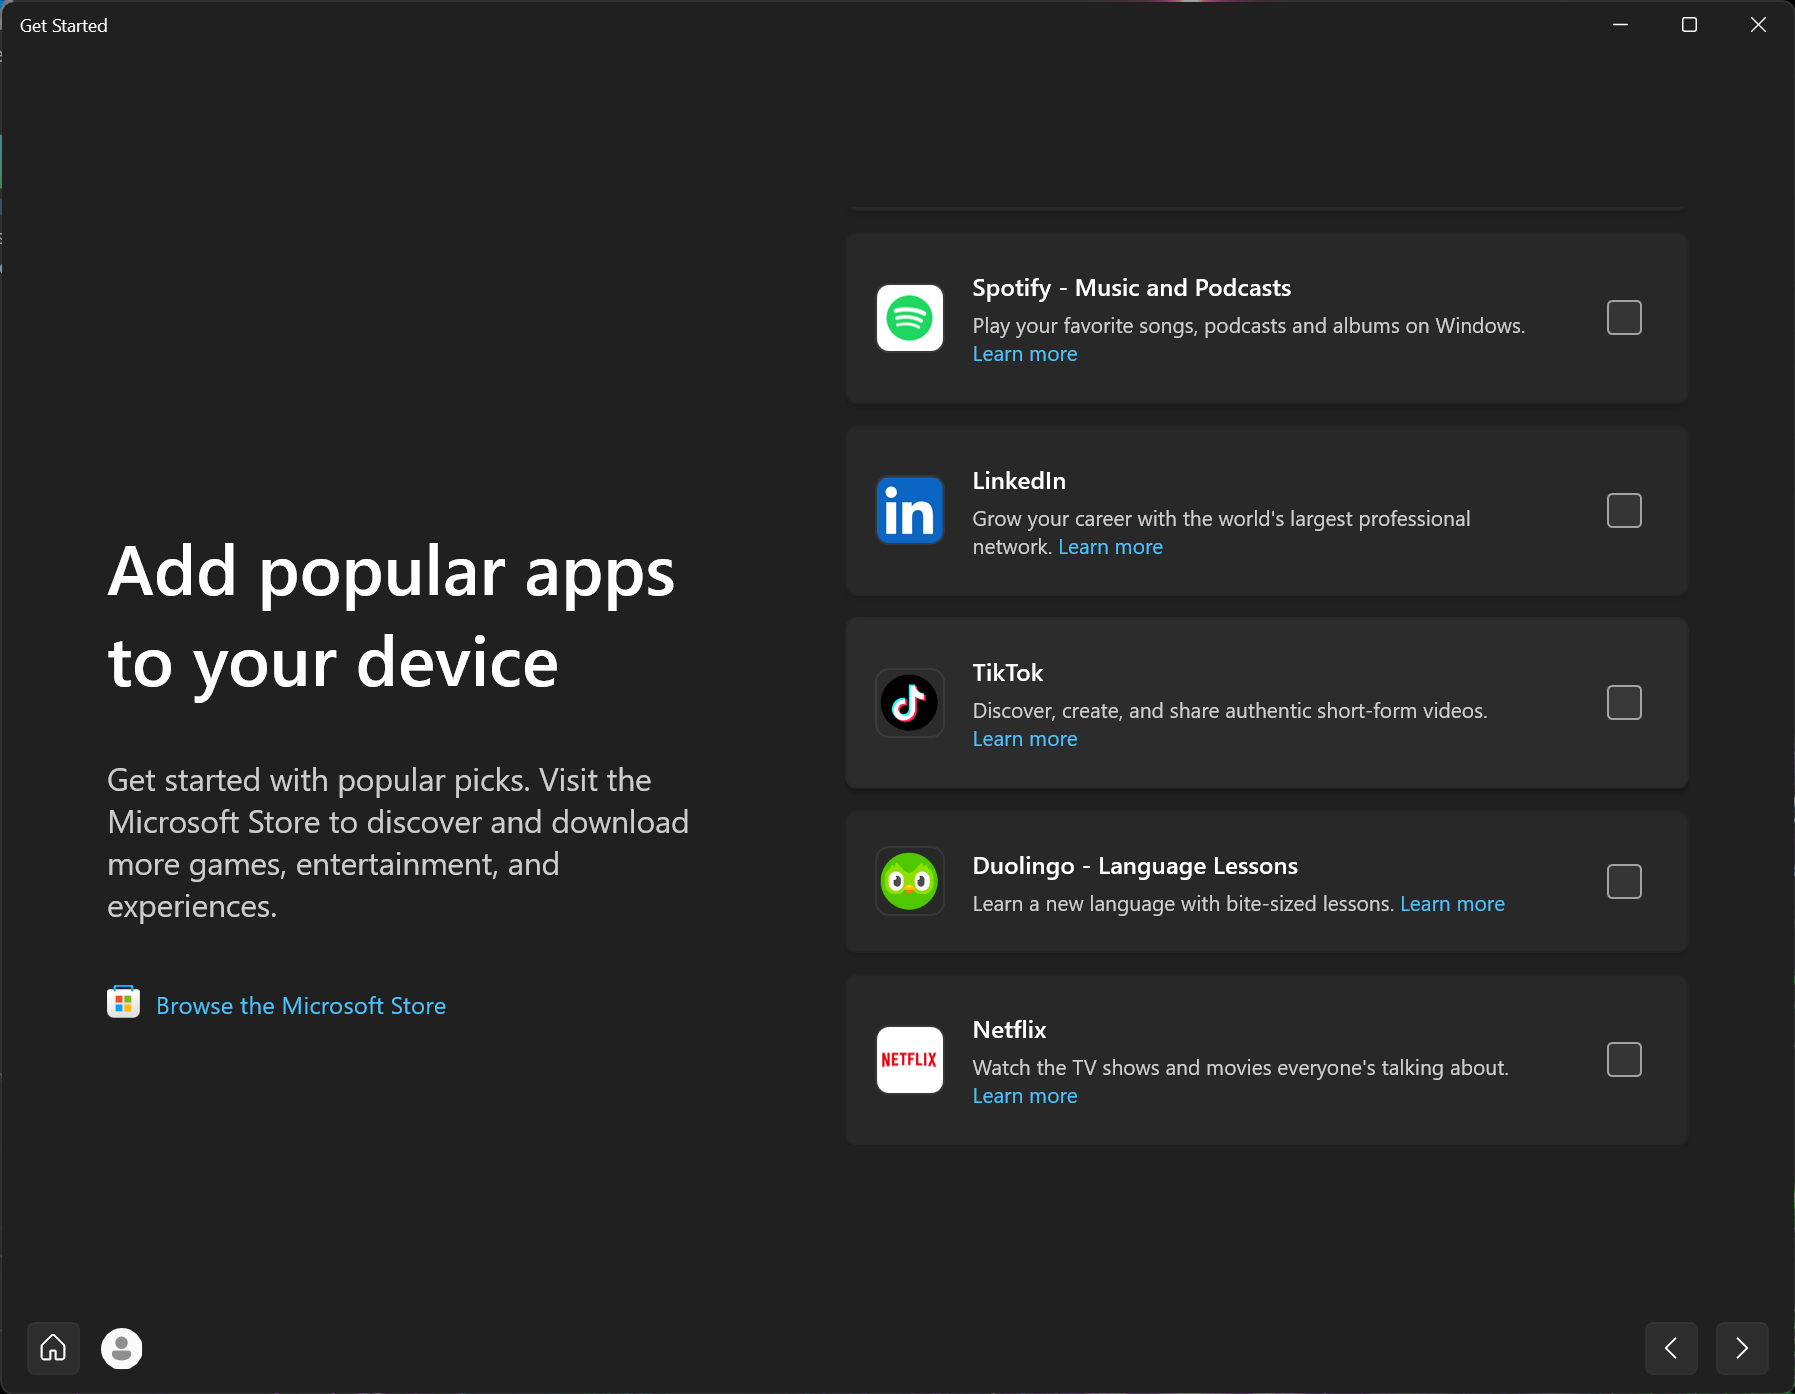
Update-ul de Windows care ar trebui să vină cu și mai multă funcționalitate pe parte de AI Agentic nu a ajuns și la noi, cel puțin nu încă. Vom avea chestii super utile de la ecranul de Get Started unde-ți alegi direct viitorul tău Agent AI, până la MXC-ul care ar trebui să diferențieze Agentul tău AI de utilizatorul tău atât la nivel local dar și la nivel de rețea, tocmai pentru a-ți permite un control mai granular asupra acțiunilor acestuia fără să te blochezi singur pentru că înainte erați amândoi pe același user.
Nu mi-am dat seama cât de utile sunt aceste lucruri până când nu ne-am lovit de cât de complicat este să folosești DGX Spark-ul care nu este pe Windows. Ok, dacă ești programator și familiarizat cu linia de comandă, sigur, DGX-ul nu te va deranja prea tare, dar majoritatea utilizatorilor, aici ne includem și pe noi, vor o experiență cât mai simplă posibil. Nu ne sperie neapărat un Linux, dar nici ușor nu este să navighezi prin el, când ai nevoie de un tutorial în 20 de pași cum să faci să-ți instalezi orice pe DGX Spark ca să reușești să te folosești de noul tău hardware. Ambele chipuri pe parte de AI sunt la fel de capabile, diferența este cum ajungi să te folosești de ele de fapt. Și faptul că în cazul în care ai nevoie de și mai multă putere de procesare și RAM pentru a îndesa modele și mai gigantice, doar pe DGX Spark îl poți grupa în clustere de maxim 4, prin ConnectX7.
Și mi se pare ironic că pentru a-mi seta AI-ul meu local ca să economisesc token-uri consumate și să țin totul cât mai privat posibil, trebuie să apelez la un AI din cloud ca să mă ghideze. Ar fi foarte amuzant să blocheze asta toate companiile mari, cum fac cu chestiile rasiste sau înjurii etc. A, vrei să înveți cum să-ți pui AI local să nu ne mai dai bani nouă? Nu știu boss, întrebarea ta nu se încadrează în terms and conditions. Descurcă-te 🙂
Deaia experiența pe RTX Spark este superioară din punctul nostru de vedere, pentru că este mult mai accesibilă. Ai instalat Windows și în câteva minute maxim ai deja un Agent băgat și ești gata de treabă. Noi am ales ca și prima dată Hermes, tocmai pentru că am vrut să vedem ce înseamnă să poți să pui un model mult mai capabil în cei 128GB de memorie. Dar la ce e bun de fapt un Agent AI local și care e diferența față de chatboții tradiționali? În primul rând nu doar te conversezi cu el ci îl poți trimite să facă lucruri pentru tine. Chestii basic, repetitive, lucruri care-ți pot ușura viața dacă le automatizezi sau dacă pui Agentul să lucreze cât timp tu faci altceva. Agenți precum Hermes există deja și se folosesc de diferite modele disponibile în cloud, dar RTX Spark face posibilă rularea de modele locale mult mai rapid ca alte alternative pe Windows, iar procesarea locală pe un hardware dedicat asigură faptul că datele tale sensibile nu ajung să antreneze un AI pe banii tăi. Și desigur că poți în continuare vibe-coda prin el.
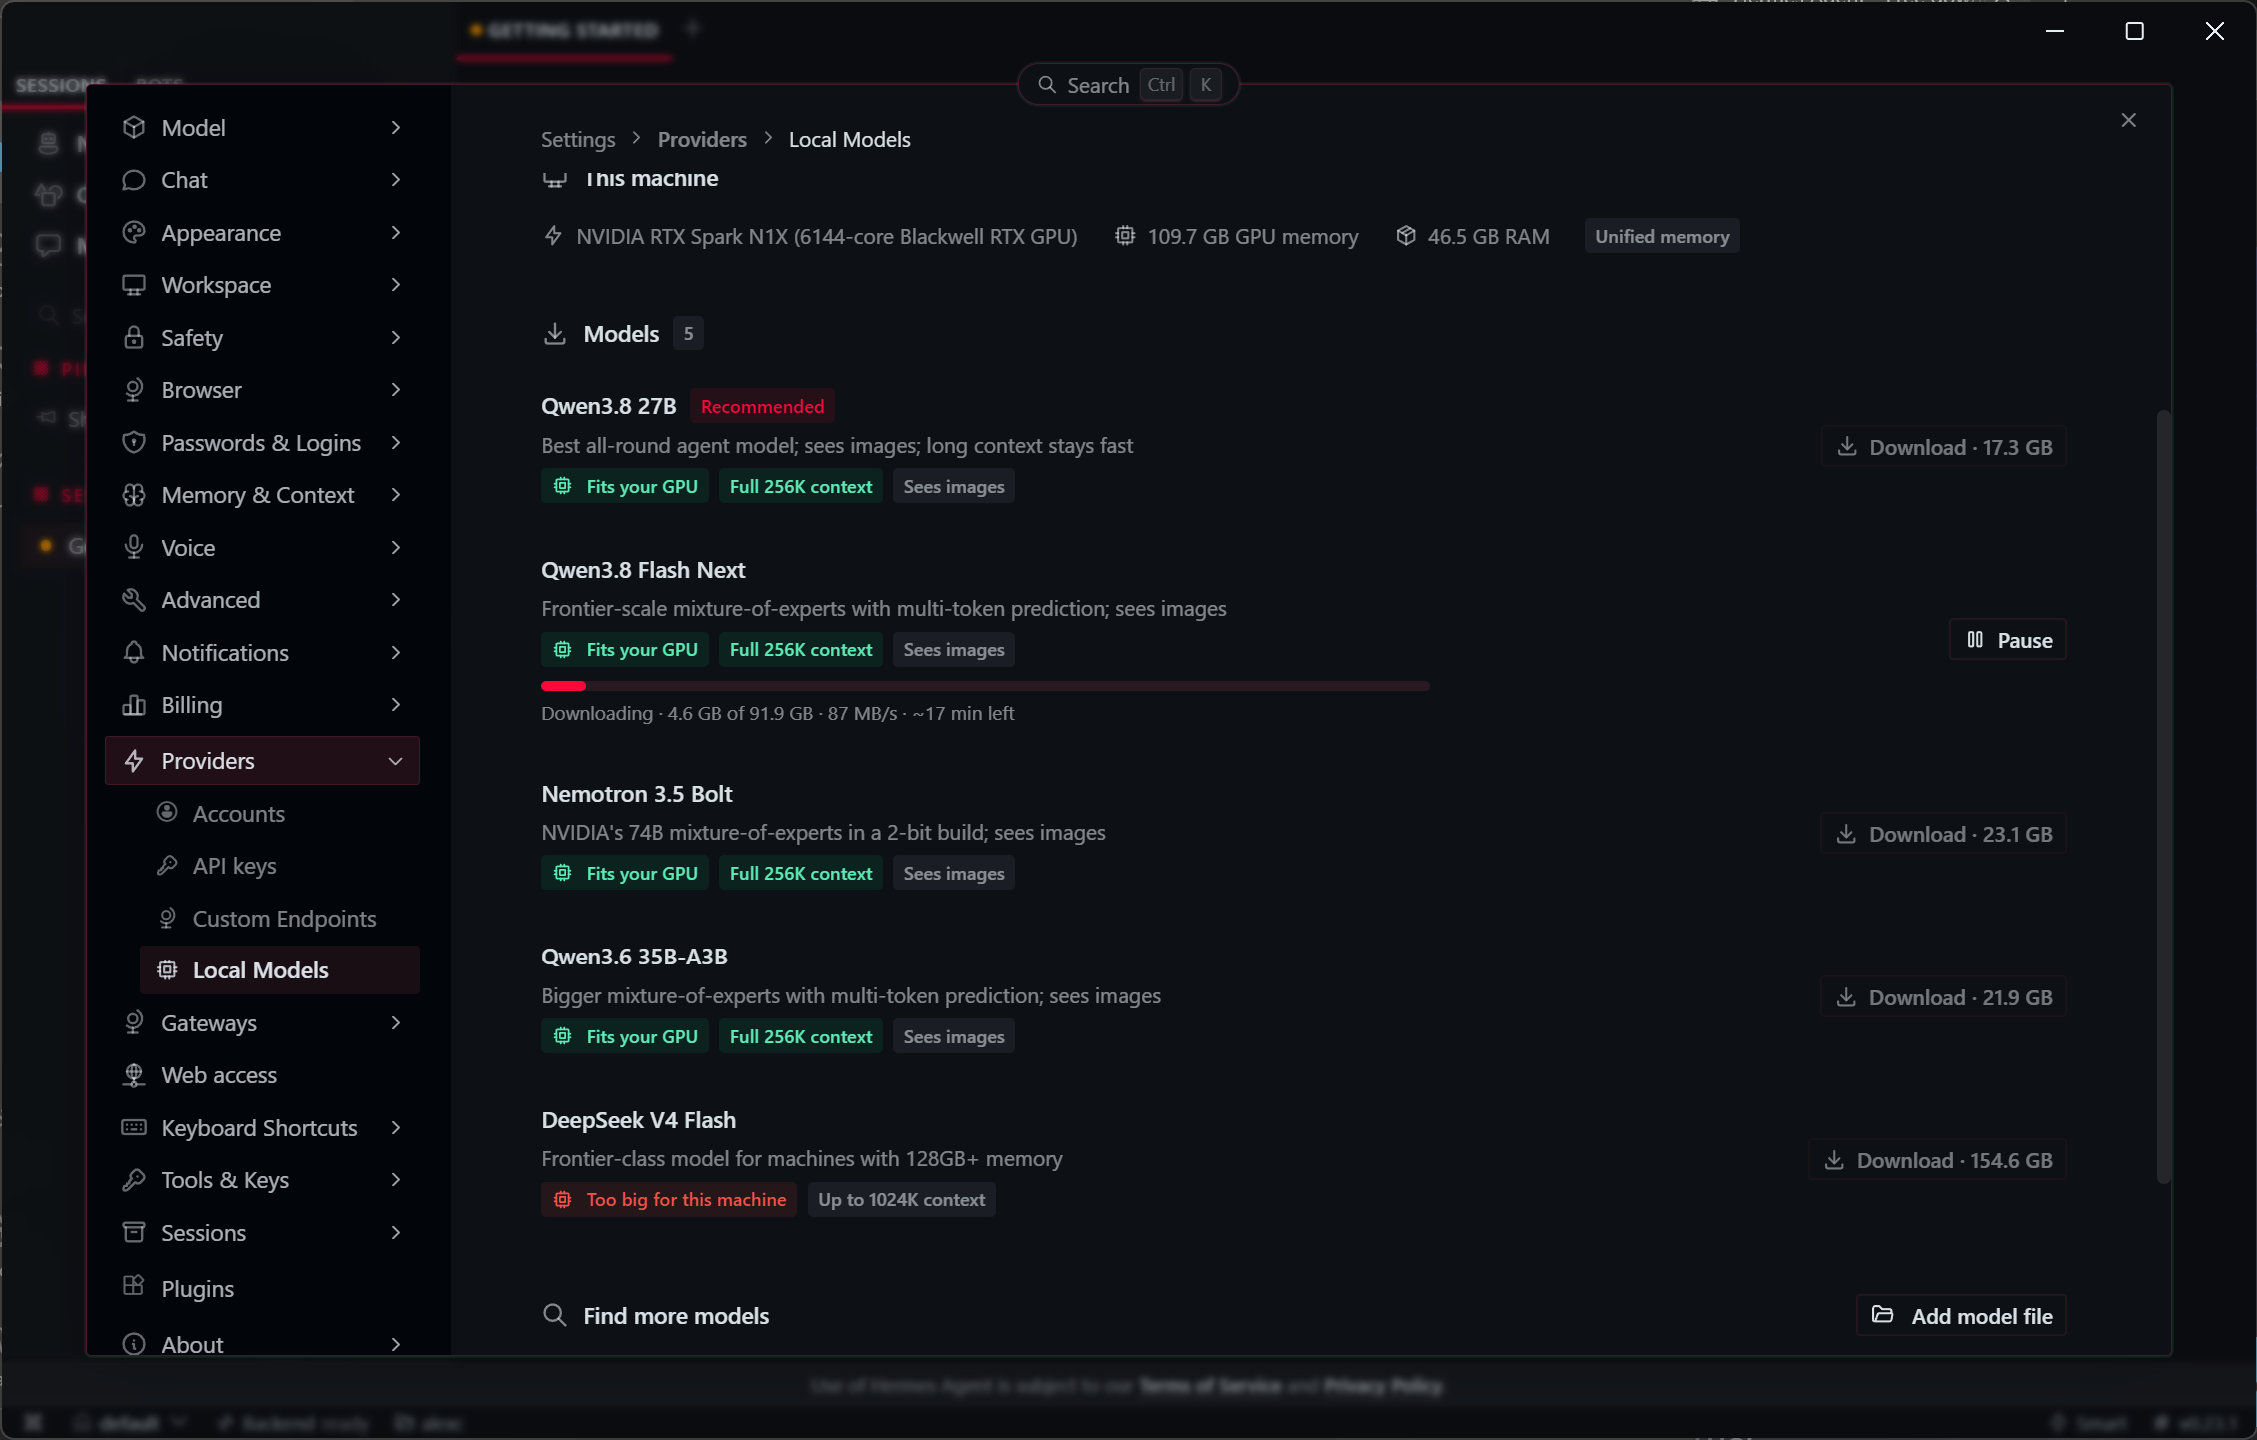
Pentru fiecare astfel de operațiune sunt alte modele recomandate, aici recomand Internetul ca sursă de inspirație, noi am ales modele all-rounder, bune la orice cum s-ar zice. Desigur că nu va fi la fel de rapid ca un model din cloud care are acces la putere de calcul și RAM nelimitate, dar pentru taskuri mai ușoare e fix ce trebuie.
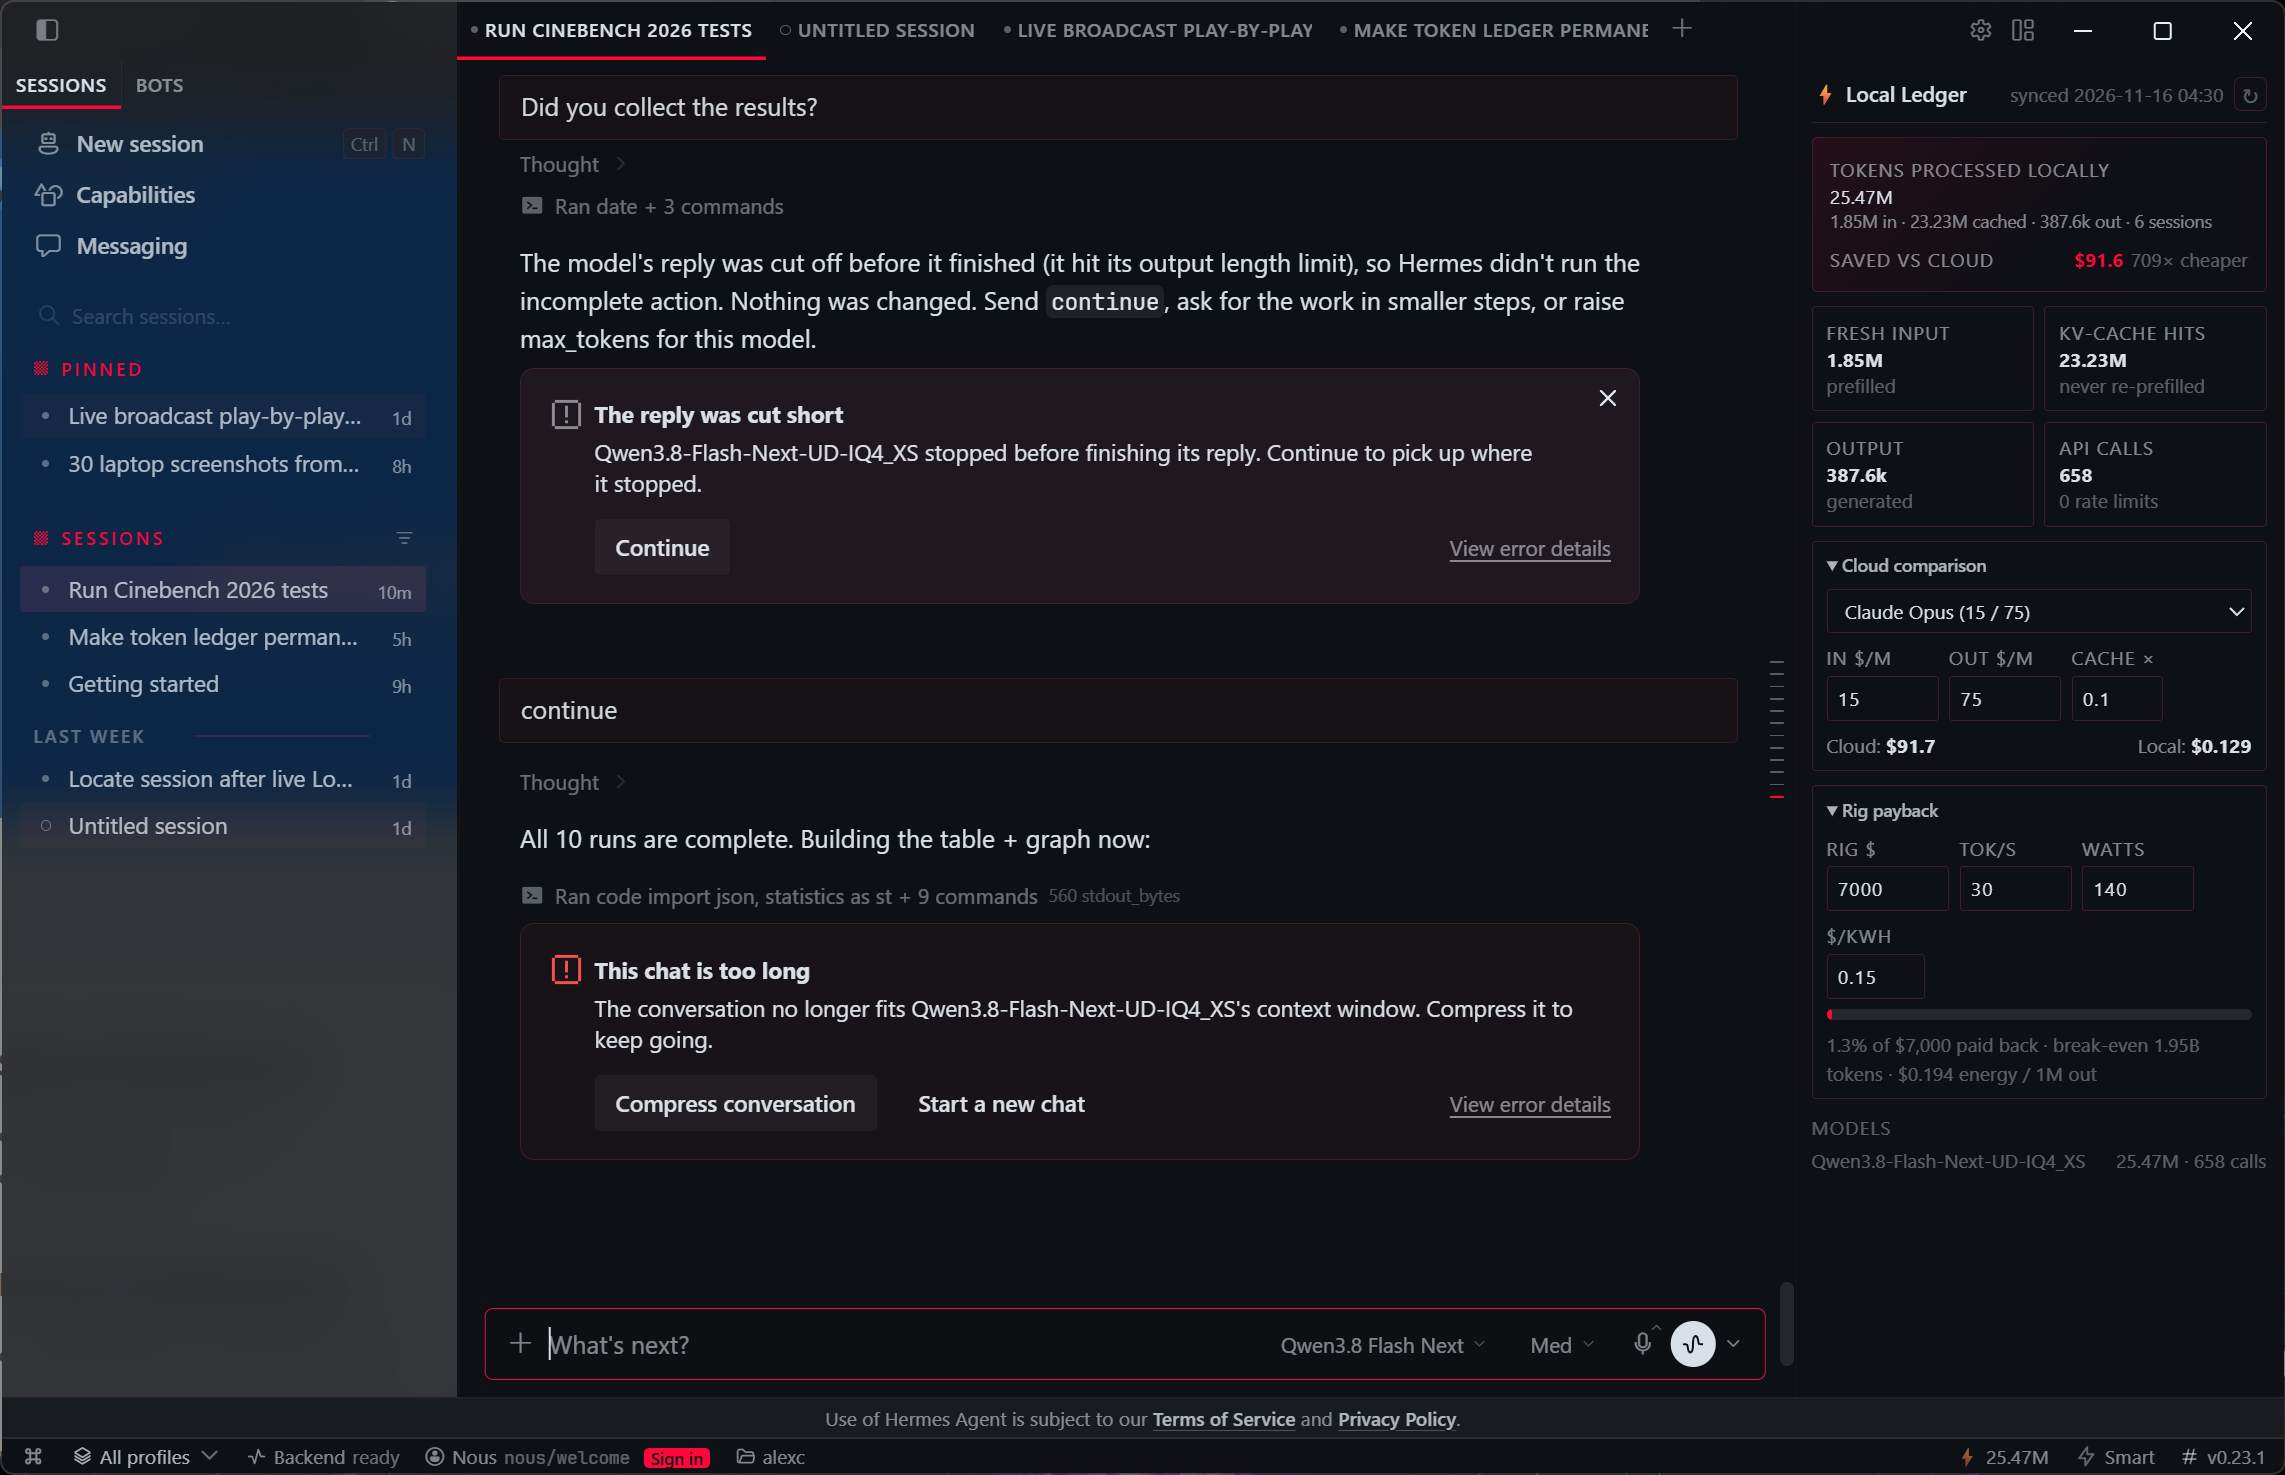
Dacă pe 64GB am ales Qwen 3.8 versiunea cu 27 miliarde de parametri, aici am trecut la următorul nivel cu Qwen 3.8 Flash Next care atinge 125 miliarde parametri pe cuantizare de 4 biți. Nu știam exact la ce să mă aștept, dar mi-am dat seama destul de rapid că modele așa de mari joacă în altă ligă. Primul lucru făcut pe ambele a fost să-mi creez în interfața lui Hermes un contor de Tokens. Pentru că vreau să văd cât de tare folosesc laptopul, dacă mă apropii măcar de declarațiile NVIDIA, cum că da, e scump domne un laptop cu RTX Spark, dar economisești până la 1000 de dolari pe lună pe el, îți scoți banii imediat, ești un fraier dacă nu îl cumperi, de fapt.
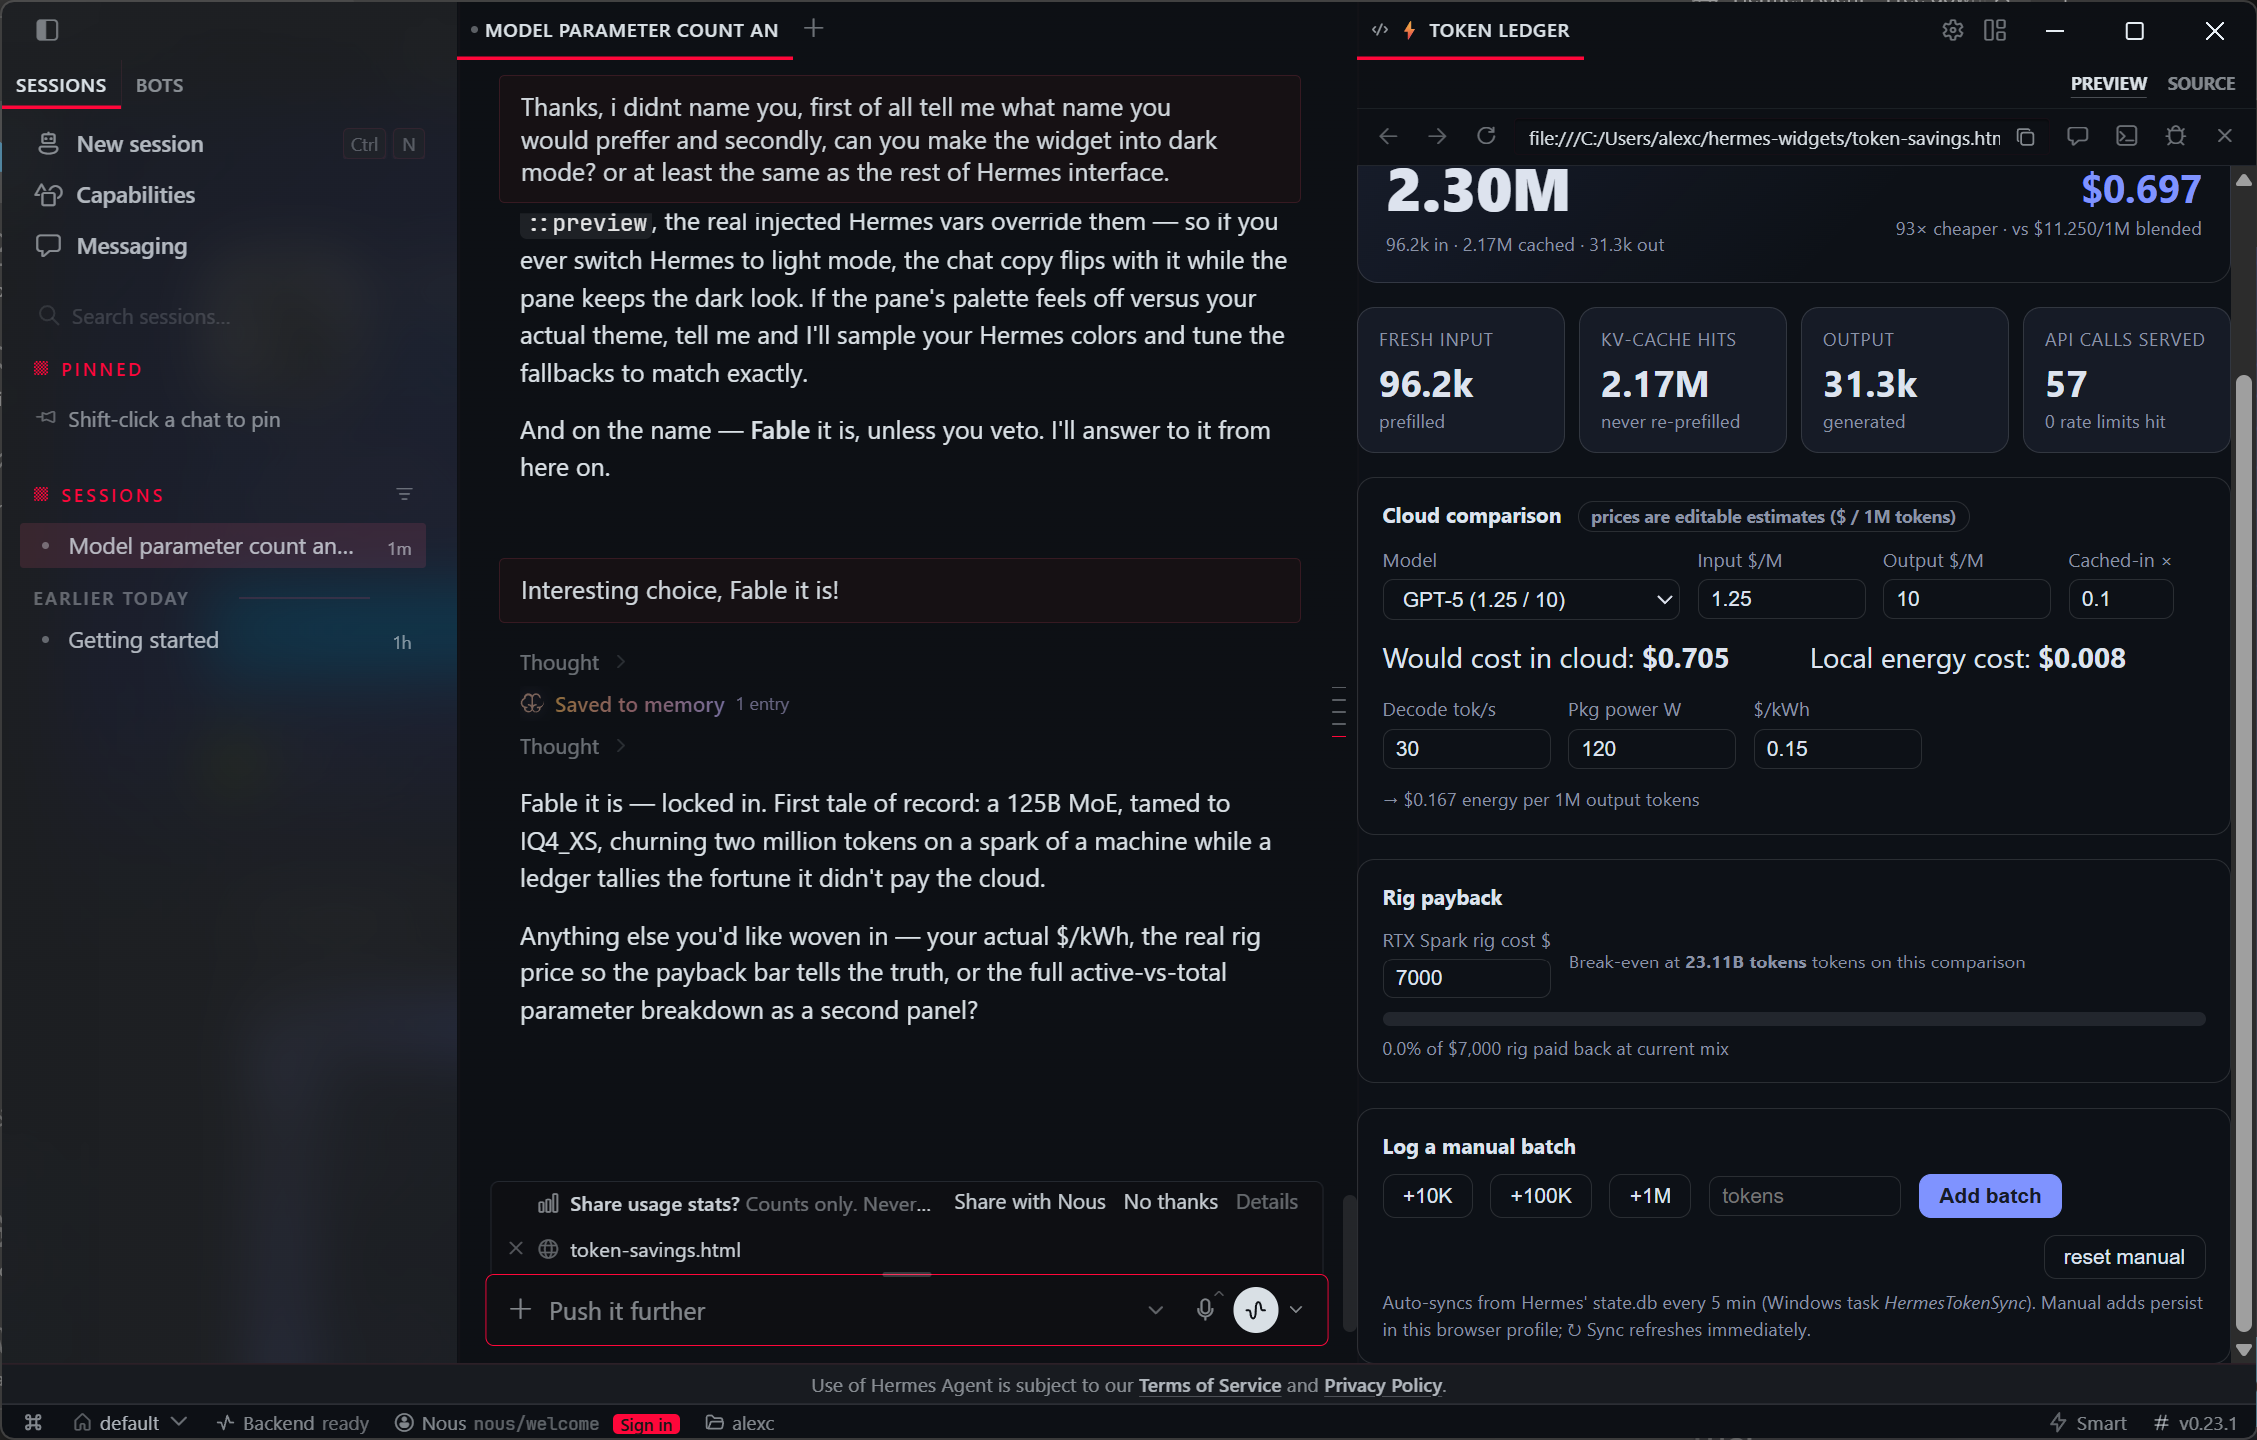
Ei bine, în 10 minute aveam un panou detaliat nu numai cu utilizarea pe fiecare fel de token, input, output, reasoning, dar și comparația cu un Frontier Model din online sau estimarea costurilor economisite în funcție de respectivul model și de consumul de curent al laptopului. Mult mai complex versus ce am obținut pe celălalt model în literalmente ORE de muncă.
Deci da, e mai rapid în răspunsuri și face treaba ceva mai bine.
Și nu ne-am oprit aici, pentru că acest agent ne poate face viața puțin mai ușoară, economisind timp. Să vă dau un exemplu de use-case pentru Hermes Agent, care și-a atribuit numele singur de Fable, aparent. Avem un review de filmat, să zicem fix pentru acest laptop. Un agent poate fi de folos aici în mai multe etape. Băieții primesc textul pe email, text pe care-l pot trimite Agentului ca să primească înapoi detalii despre ce cadre ar fi utile cu respectivul device. Dacă am vorbit de porturi, de aerisire, ce aplicații menționez și dacă trec și prin jocuri. Fără să stea să citească review-ul rând cu rând. Mai departe, se filmează tot, se montează și se pune pe Youtube, următorul nostru task este de obicei să publicăm și pe site respectivul review. Dacă nu știați, majoritatea review-urilor de produs sunt și pe site-ul nostru zonait.ro, ca să fie luate de AI să se antreneze pe ele, nu de alta. Iar pentru site avem nevoie de poze, lucru care de obicei implică obținerea pozelor, fie de noi, fie de Nico sau Stelian în timpul sau după editarea clipului. Din nou, extra muncă repetitivă pe care o poți face cu Agentul tău AI.
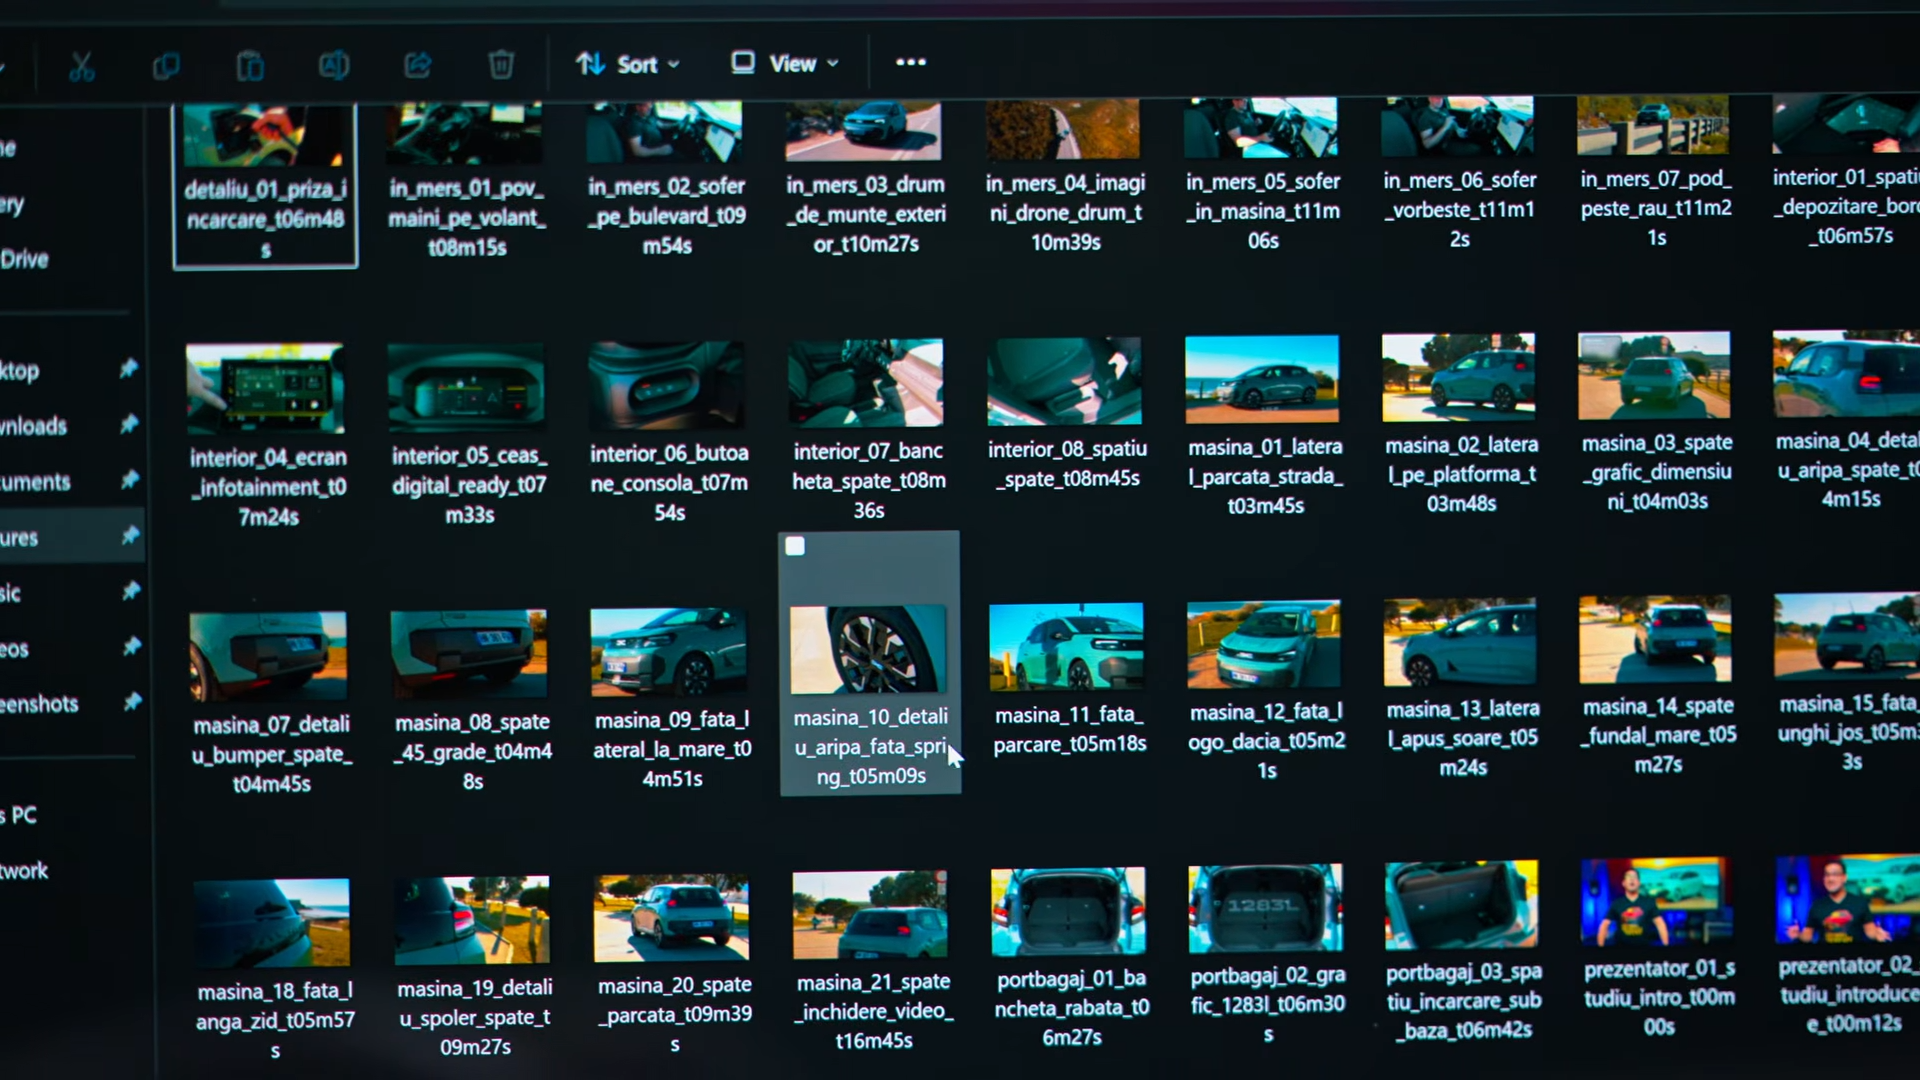
Bun, zis și făcut, i-am dat clipul cu DGX Spark-ul și i-am cerut să-mi facă screenshots unde apare produsul, nu fața mea, 30 la număr ca să am de unde alege. A făcut treabă în general bună chiar dacă a mai scăpat o poză în care-l țineam eu în mână, dar înțeleg confuzia că într-adevăr apare și produsul acolo. Am mai repetat procedura pe un alt clip review de laptop, cu același succes în mare bun, după care am observat ceva și mai interesant. Agentul „învață”, a se citi își optimizează traseul. Toate interacțiunile lui atât la nivel local dar și online se manifestă prin Skills, plugins sau conectori, atât cu aplicații dar și site-uri în sine.
Practic îndată ce repetă anumite acțiuni își va construi un skill în jurul acestora ca să le facă și mai rapid. Un sistem de etape și shortcuts bine definite ca să nu mai piardă timp data viitoare. Acum știe că vreau în general screenshoturi cu produse, nu mai trebuie să-i menționez câte vreau sau la ce rezoluție. Apelez skill-ul, îi dau o țintă și se descurcă. Asta consumă și mai puțină putere de procesare, deci implicit curent.
Poți cu el să corectezi ce scrii, typos, greșeli, punctuație sau să transformi un script de video într-unul pentru review text, unde nu mai au sens anumite exprimări, merge adăugată niște structură, câteva repetiții pentru SEO, repetiții pe care nu le faci pe video, subcapitole și renunțat la outro, semnătură etc. Plus poți corela asta și cu screenshoturile făcute anterior, la fel, tot de agent și postatul pe site devine brusc considerabil mai ușor. Totul în siguranța procesării locale. Că de multe ori ai de-a face cu produse nelansate și mai bine nu riști spargerea unui NDA, embargou etc corectând cu un AI online posibilele greșeli.
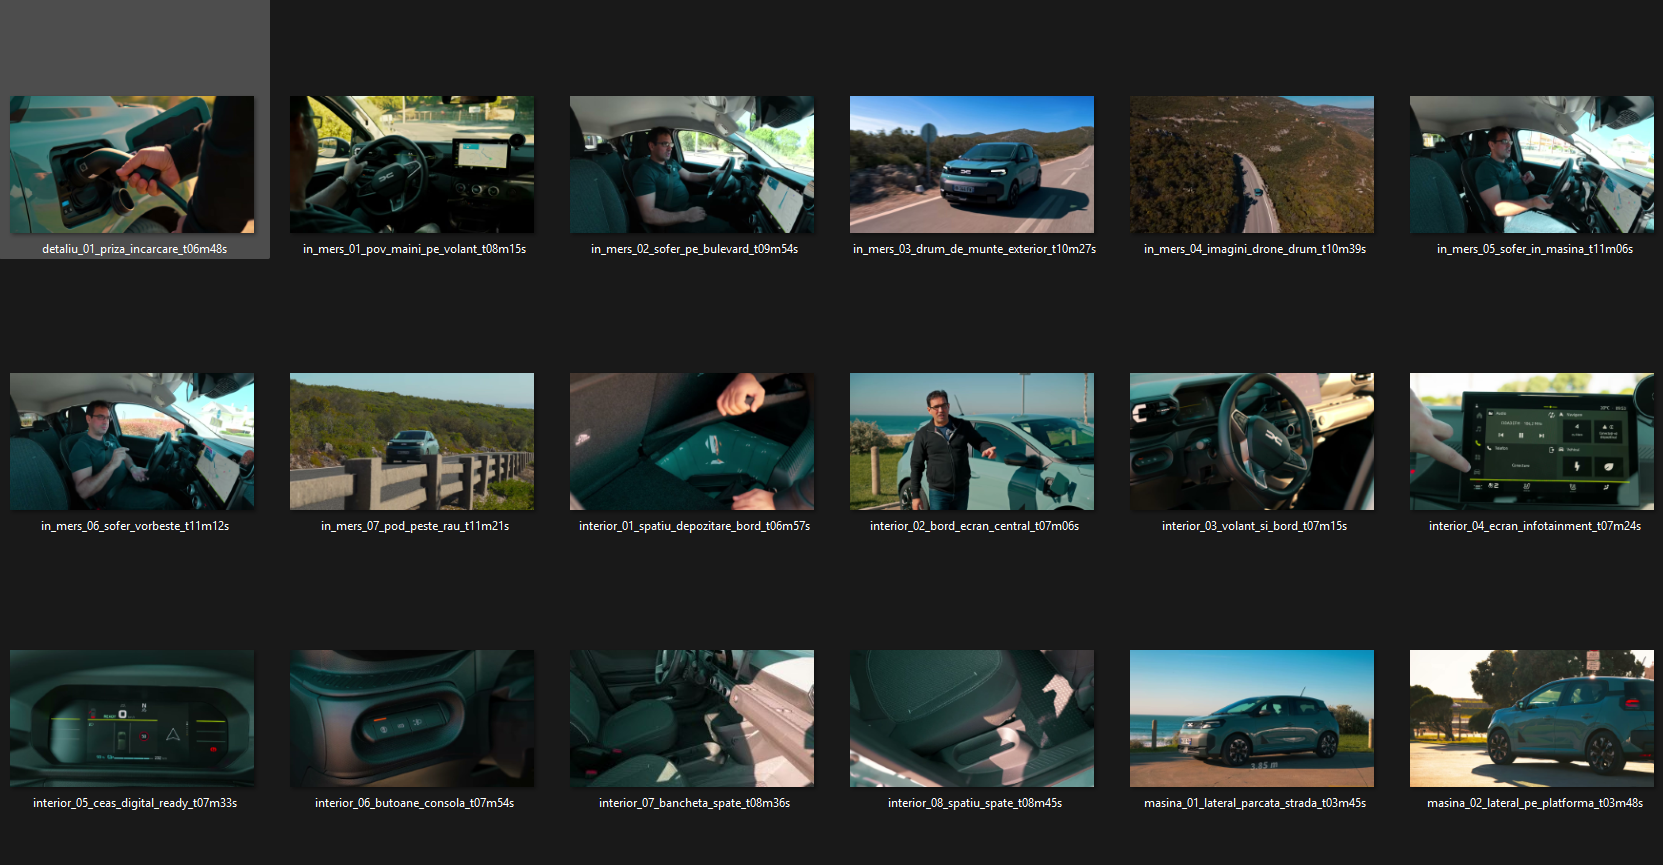
O altă treabă super practică, mai ales într-un flux de producție ca al nostru, este organizarea și redenumirea cadrelor brute (B-roll) imediat după filmare. Când descarci de pe card 80 de fișiere care se numesc toate C0014.MP4 sau DJI_0082.MOV, cineva trebuie să stea să le deschidă pe rând și să le sorteze pe foldere pentru Nico sau Stelian, ca să nu piardă ei jumătate de zi căutând prin timeline-ul DaVinci un cadru cu porturile din stânga. Poți pune agentul local, cu ajutorul unui model vizual, să scaneze rapid clipurile, să le dea rename, gen YogaPro9_tastatura_close-up.mp4 și să le mute singur în folderele aferente. Iarăși, zero fișiere urcate în cloud, zero risc să scapi pe internet un produs aflat încă sub NDA, și scutești o grămadă de muncă mecanică.
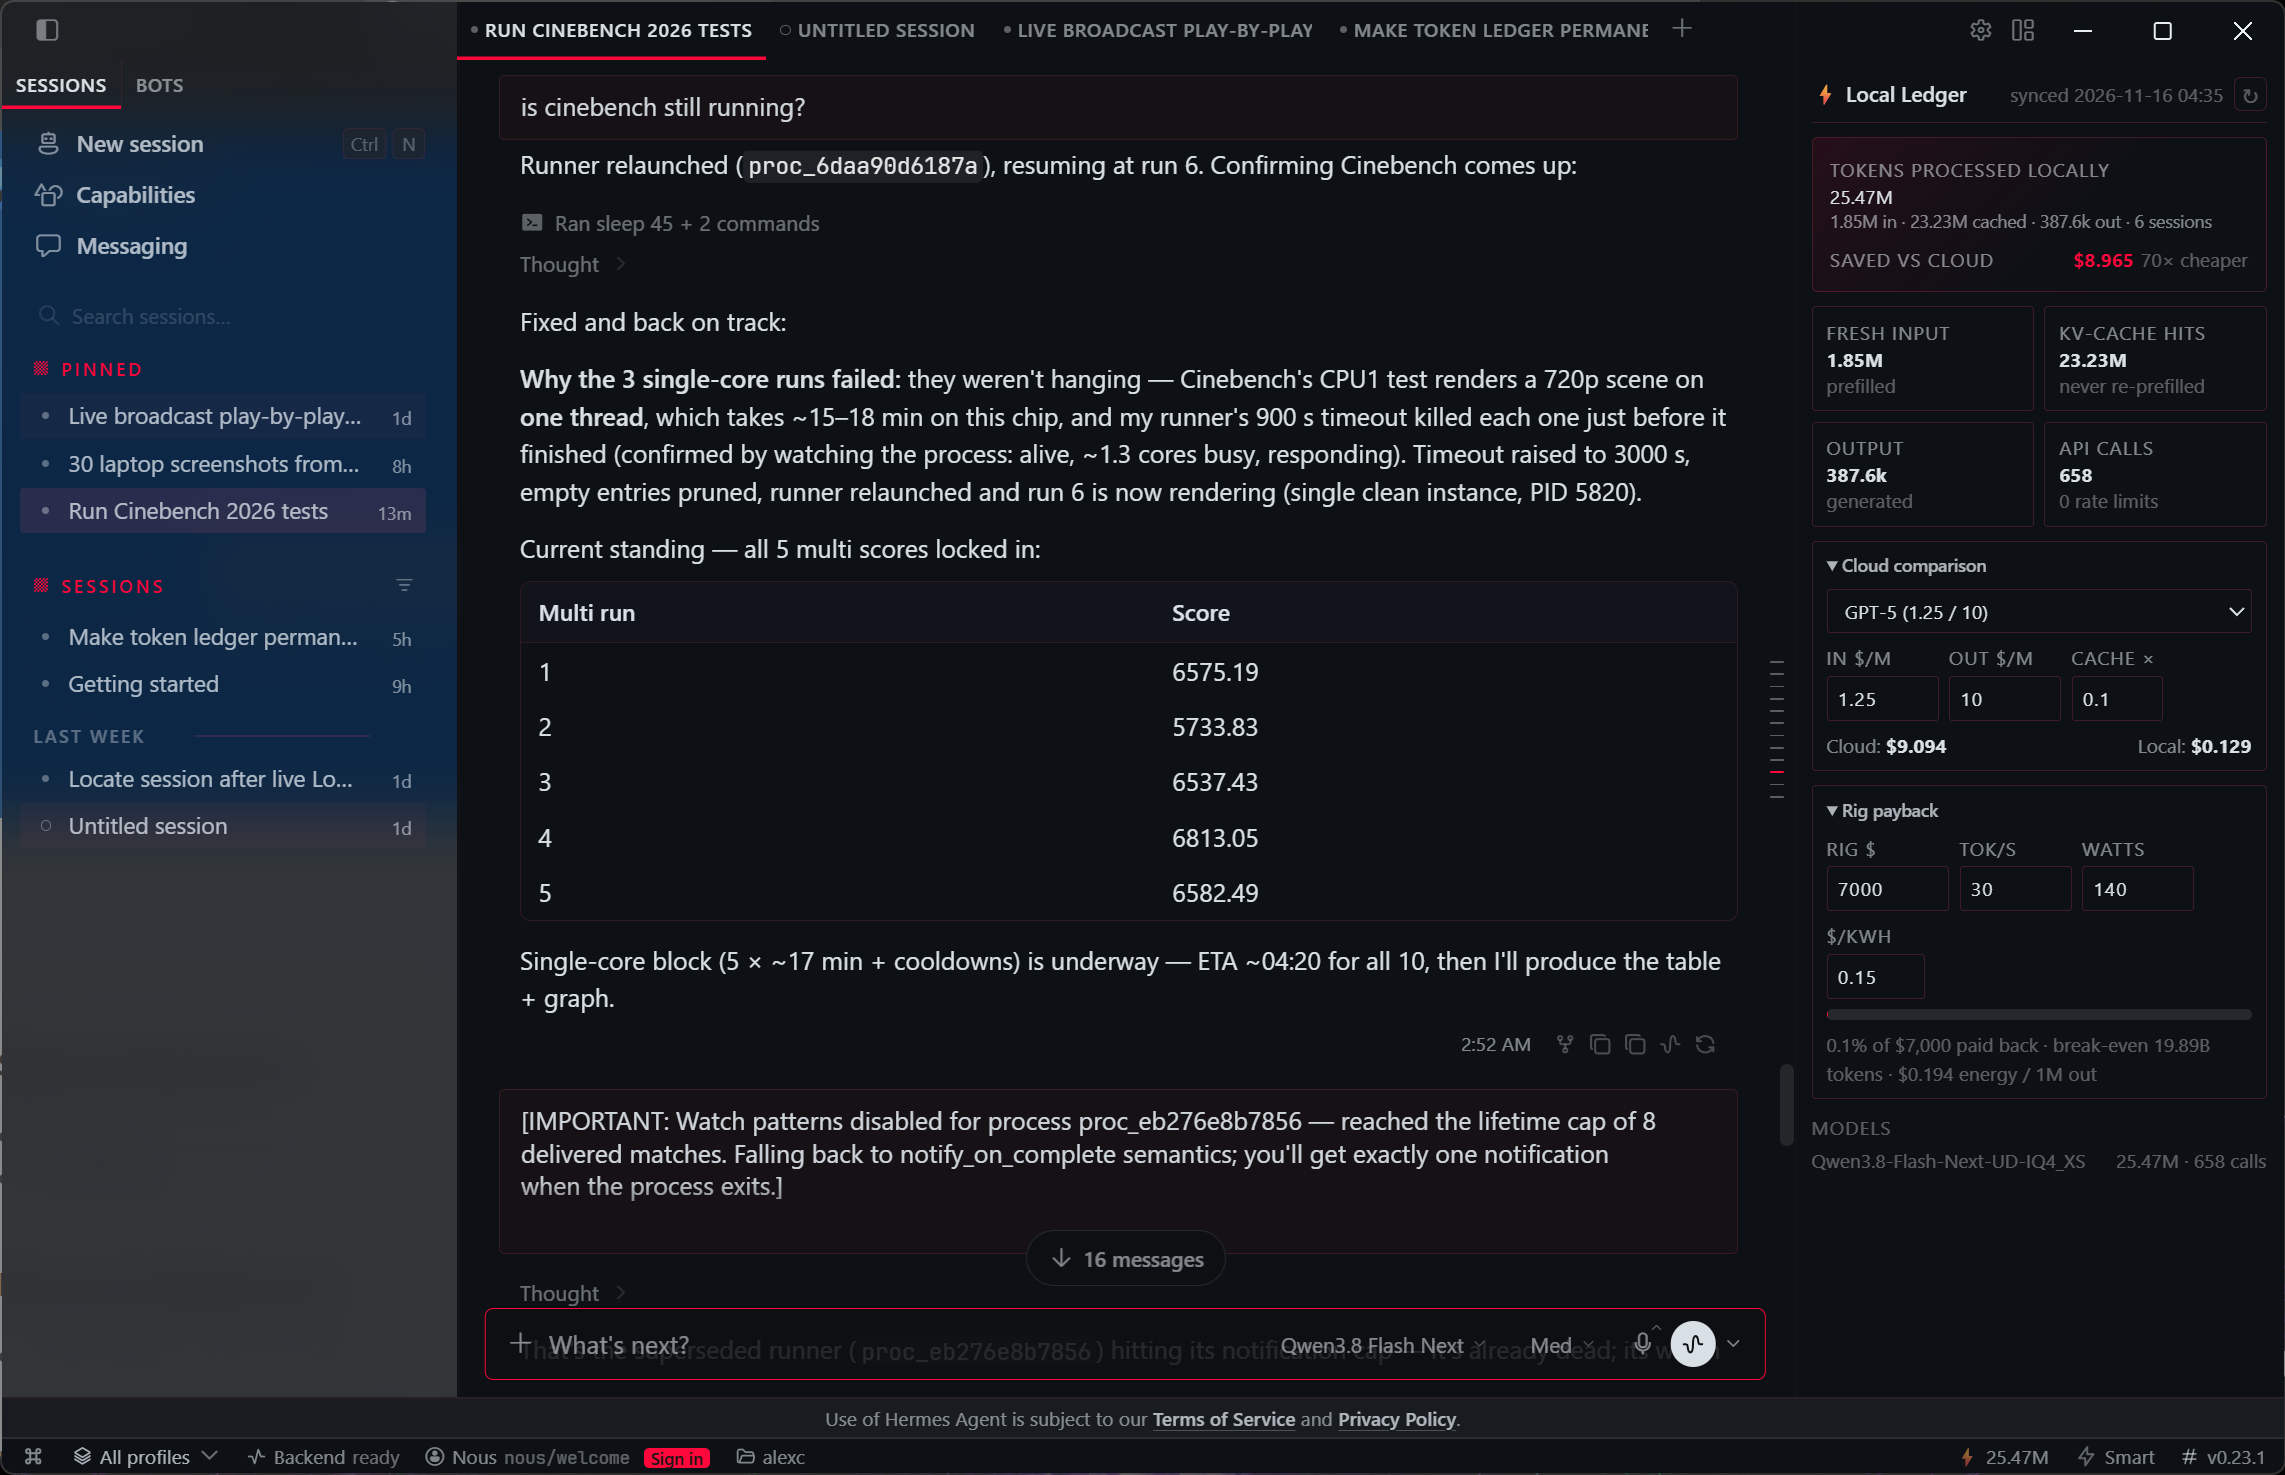
Am mers și mai departe, m-am gândit ce să mai automatizez pe acest Yoga dotat cu RTX Spark? Testarea… Mi-a venit mie ideea: Ce ar fi dacă-l pun să se auto-testeze? Sună bine, nu? În teorie da, dar în practică nu prea. Pentru că dacă-l trimiți să-și ruleze singur niște Cinebench 2026, puterea de procesare va fi distribuită nu numai către Cinebench 2026, dar și către Agentul AI pe care l-ai trimis să facă treaba asta. Și astfel vei avea niște rezultate ceva mai slabe. Ceea ce mi s-a și întâmplat, de la 7200 de puncte atinse în multi-core am scăzut către 6500-6800. Nu e neapărat rău, poți face un baseline singur și repeți testul cu AI să vezi stabilitatea și extrapolezi. Dar pare că mă complic de dragul de a mă complica. Ce nu suferă atât de tare este testarea de SSD, de exemplu CrystalDiskMark, unde pot trimite agentul să-mi facă 10 pass-uri ale testului, o medie și chiar și un tabel dacă am chef. Încă o dată un capitol unde poate fi de folos, încă o dată la nivel local.
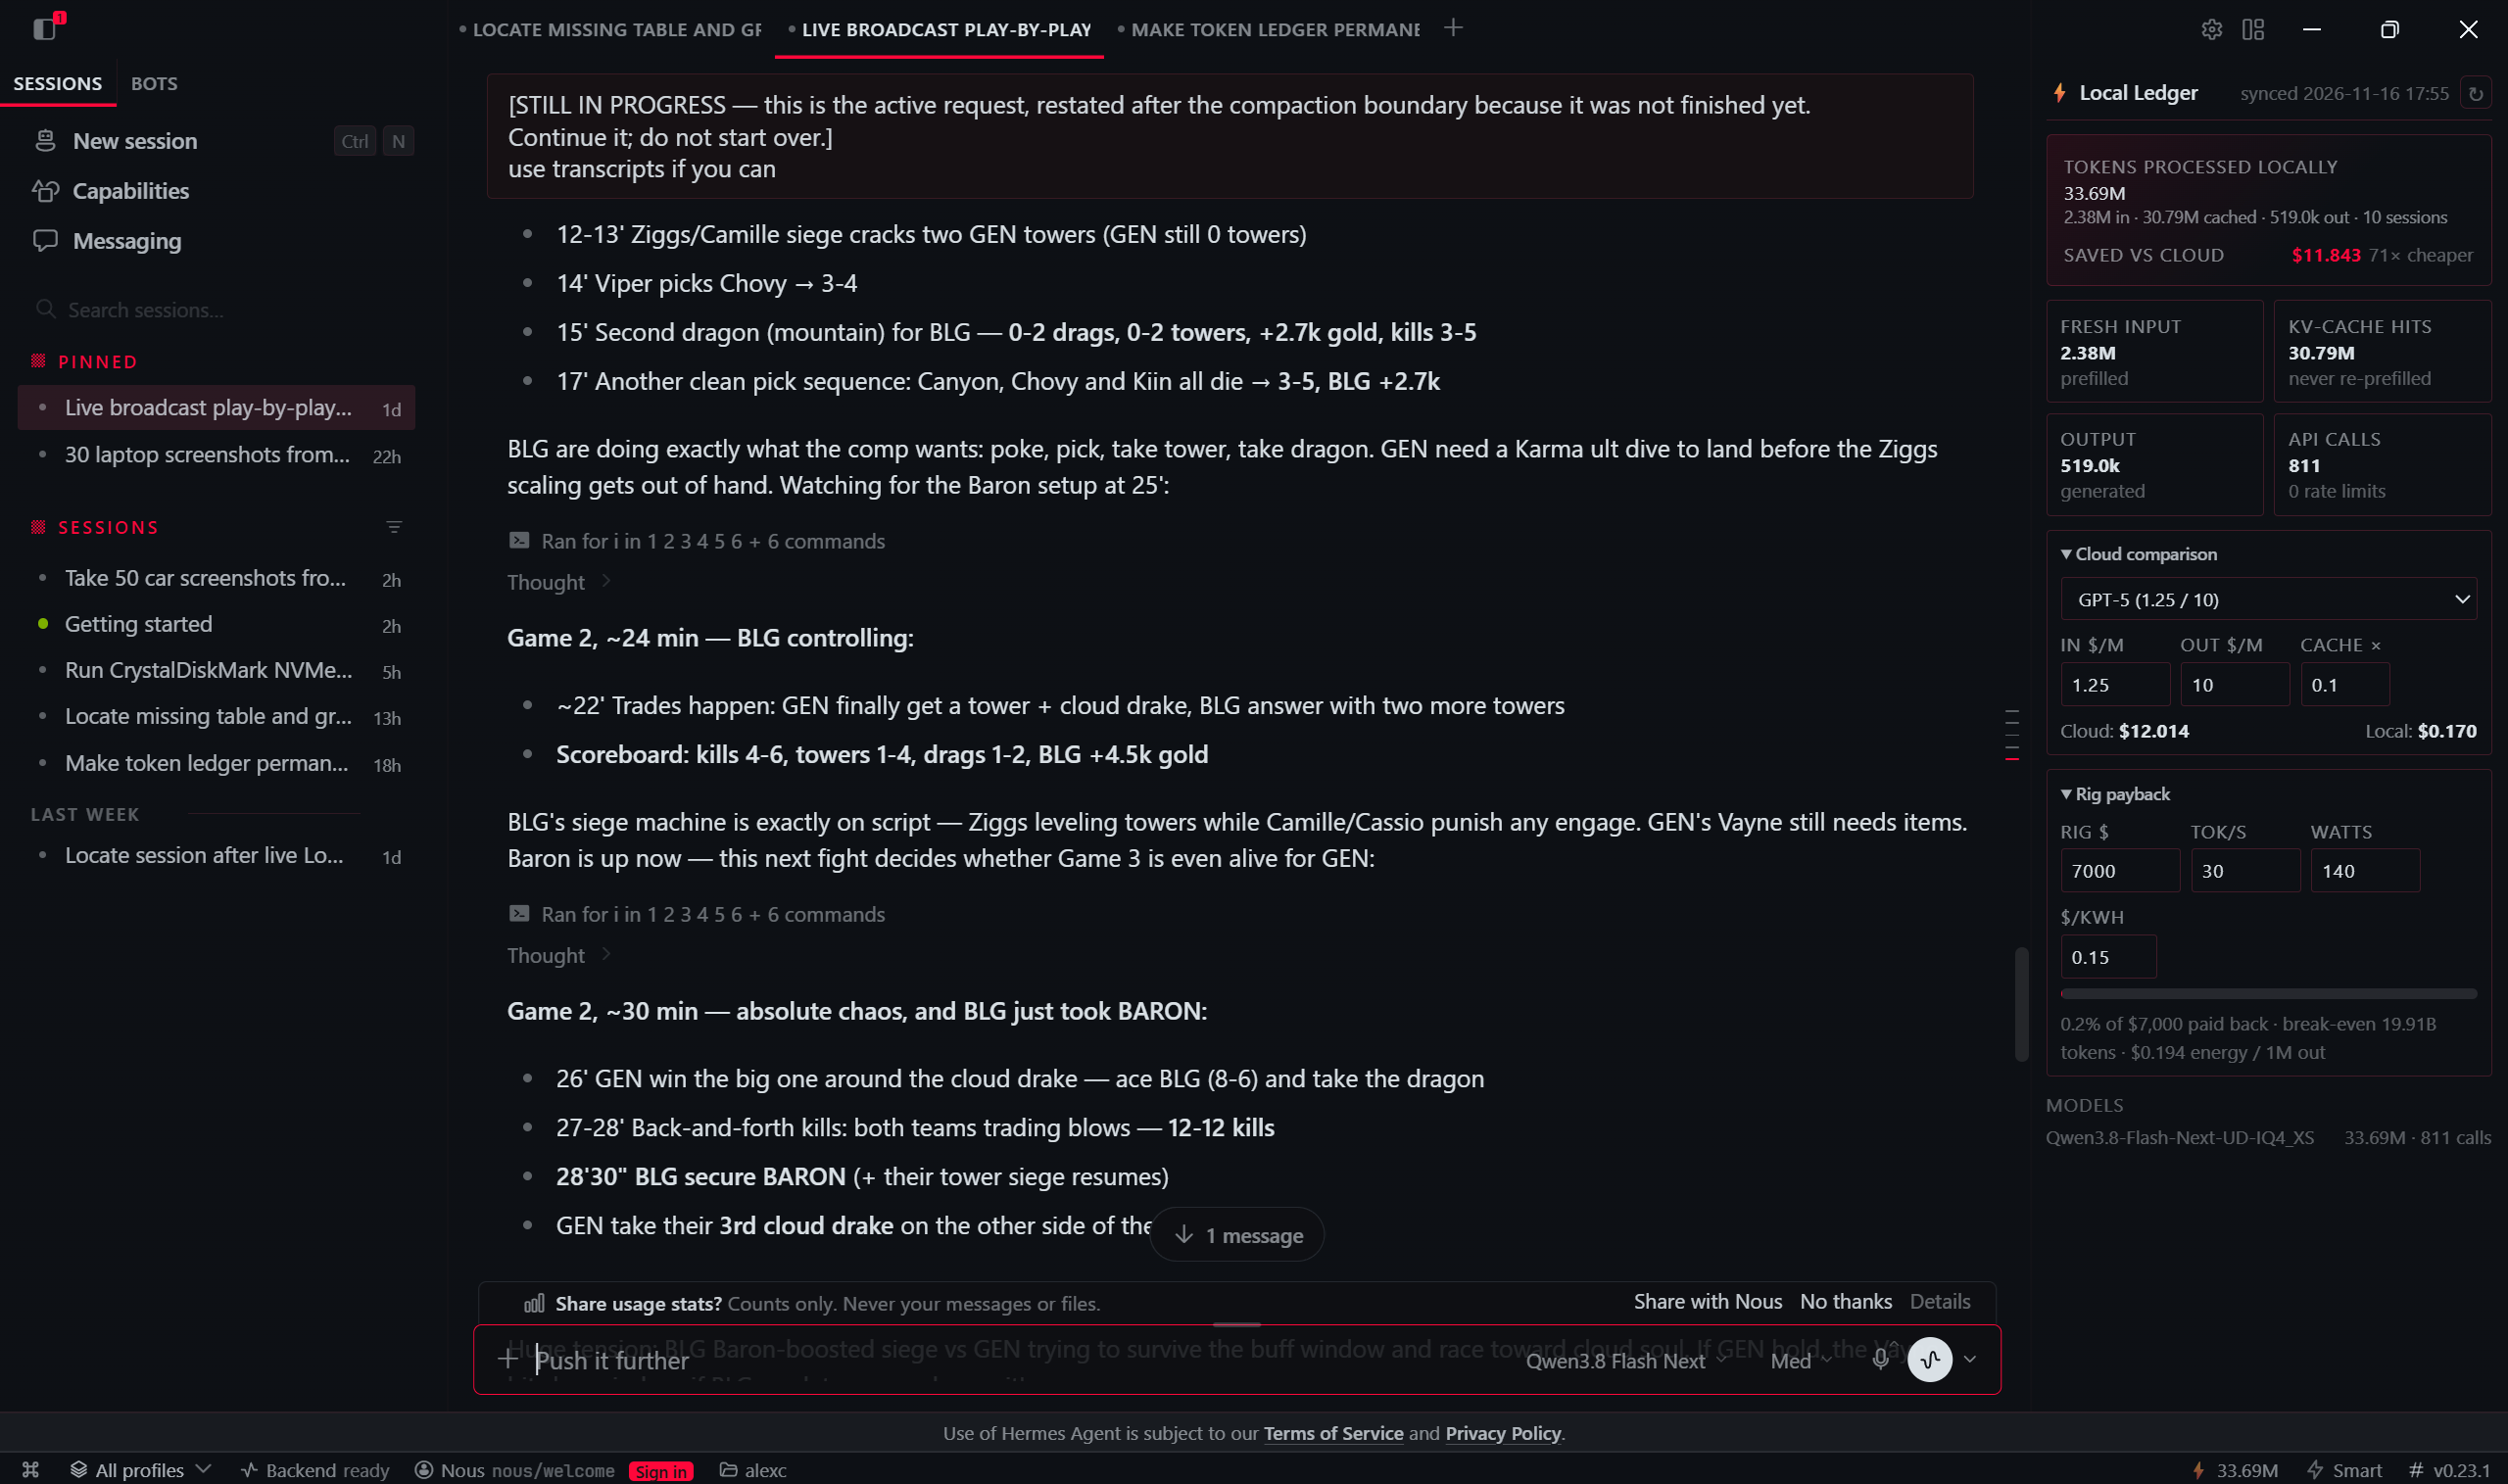
Continuăm cu chinuitul lui Hermes în multe alte scenarii. În weekend au fost finalele Worlds, aici poți include orice fel de eveniment, unde ai un link de transmisie live, o cursă de Formula 1, meciul ăla bun de fotbal, ce vreți voi. Doar că noi aveam alte planuri, am asamblat LEGO cu fetele, bine, dacă le întrebi pe ele mai mult le încurcam, dar hey, am încercat. Cât timp tu te bucuri de LEGO sau alte activități în familie, agentul tău poate să stea să se uite la meci și să-ți ofere rezumate timpurii, ce s-a mai întâmplat, cine a greșit, cine nu și de ce a câștigat echipa care a câștigat. Mișto nu? Sigur, nu trăiești la fel momentul ca și cum ai vedea golul dat live de echipa preferată, dar nici nu pierzi tot ca să-ți iei spoiler după instant cum deschizi social media. Pentru Worlds a mers chiar bine, deși la meciul 3 și-a umplut contextul, moment în care a trebuit să intervin în setări să-l duc la maxim. Dar din nou, după ce și-a terminat treaba, Hermes și-a construit un skill, ca data viitoare să nu fie nevoie de atâtea detalii sau să vadă toată conversația anterioară ca să știe ce are de făcut.
Bineînțeles că poți răspunde cu el la mailuri, trimite follow-ups în cazul în care nu ți s-a răspuns la mesaje și poți reorganiza pe diferite criterii folderul ăla de poze unde ai aruncat 50 de mii de cadre random. Îl poți pune să analizeze respectivele poze, iar rezultatele pot varia, desigur, în continuare gafează și nu trebuie să aveți încredere 100% în el, totul se verifică.
Chiar sunt curios, voi ce ați face cu un astfel de Agent? care este primul task pe care-l trimiteți să efectueze? Vă aștept în comentarii.
NVIDIA insista cu tot felul de scenarii amuzante, printre care preferatul nostru era să-l trimiți să-ți caute prin email și prin calculator toate facturile și toate cheltuielile relevante pentru contabilitate, pentru că te-ai trezit fără chef să faci tu asta, așa că pui agentul să le caute și să le trimită mai departe către contabilă. Reacția mea la acest exemplu a fost desigur… no fucking way. Îmi ia gâtul contabila dacă-i trimit ceva greșit care poate rezulta în probleme ulterior cu anaful.
Dar toată lumea din AI acum se poartă de parcă totul e minunat, modelele astea nu greșesc niciodată, lucrează perfect și nu trebuie să avem decât 100% încredere oarbă în ele, and I call bullshit on that one. Oricât de bun ar fi cel mai cel model, tot gafează, tot halucinează niște chestii aberante din când în când. Tot la o prezentare NVIDIA tot pentru RTX Spark, oamenii foloseau un Agent care verifica zilnic crash-urile de pe o aplicație și vibe-coda el update-uri automat, update-uri pe care le trimiteau direct în producție băieții. Și după aceiași băieți mândrii de ce face Agentul lor singur se uitau ciudat la mine, singurul care întreba boss… da nu verificăm și noi rezultatele? Așa încredere oarbă? Da, și după ne mirăm cum moare Microsoft o zi întreagă random.
Bateria te va ține mai puțin ca în cazul ProArt P16-lui testat anterior, pentru că Yoga Pro 9 cu RTX Spark are o capacitate ușor mai mică, la 92.5Whr față de 99.9 pentru ProArt. Nu va fi o diferență colosală în utilizare normală, dar vedem o scădere de aproape 10% în vizionare de conținut multimedia sau editare text. Dacă-l forjezi la maxim pe procesare AI sau în gaming, tot în jur de o oră te va ține până apelezi la priză. În continuare mi se pare foarte interesant faptul că poți obține fix aceiași performanță pe priză și pe baterie.
Concluzii
În concluzie, RTX Spark este o mașinărie foarte interesantă, chiar dacă este o arhitectură ușor veche și extrem de scumpă în acest moment datorită prețurilor exorbitante pentru memorie, prețuri accentuate de disperarea cu care înghit toate data centerele RAMi cu tona.
Parteneriatul cu Windows pare să miște acul în direcția arhitecturii ARM dar și în materie de suport pentru noul val de popularitate pentru AI-ul Agentic, val pe care-l urmează și demandul pentru hardware capabil să ruleze AI-uri locale.
Versatilitatea oferită de 128GB de memorie unificată foarte rapidă este, de fapt, adevăratul motiv pentru care există această platformă. Abia la capacitatea asta scapi de compromisuri: poți ține în paralel un proiect greu de editare, un model mare în memorie și un context uriaș, fără să sugrumi sistemul, fără să depinzi de abonamente lunare care se scumpesc peste noapte și fără să-ți trimiți datele sensibile pe serverele altcuiva.
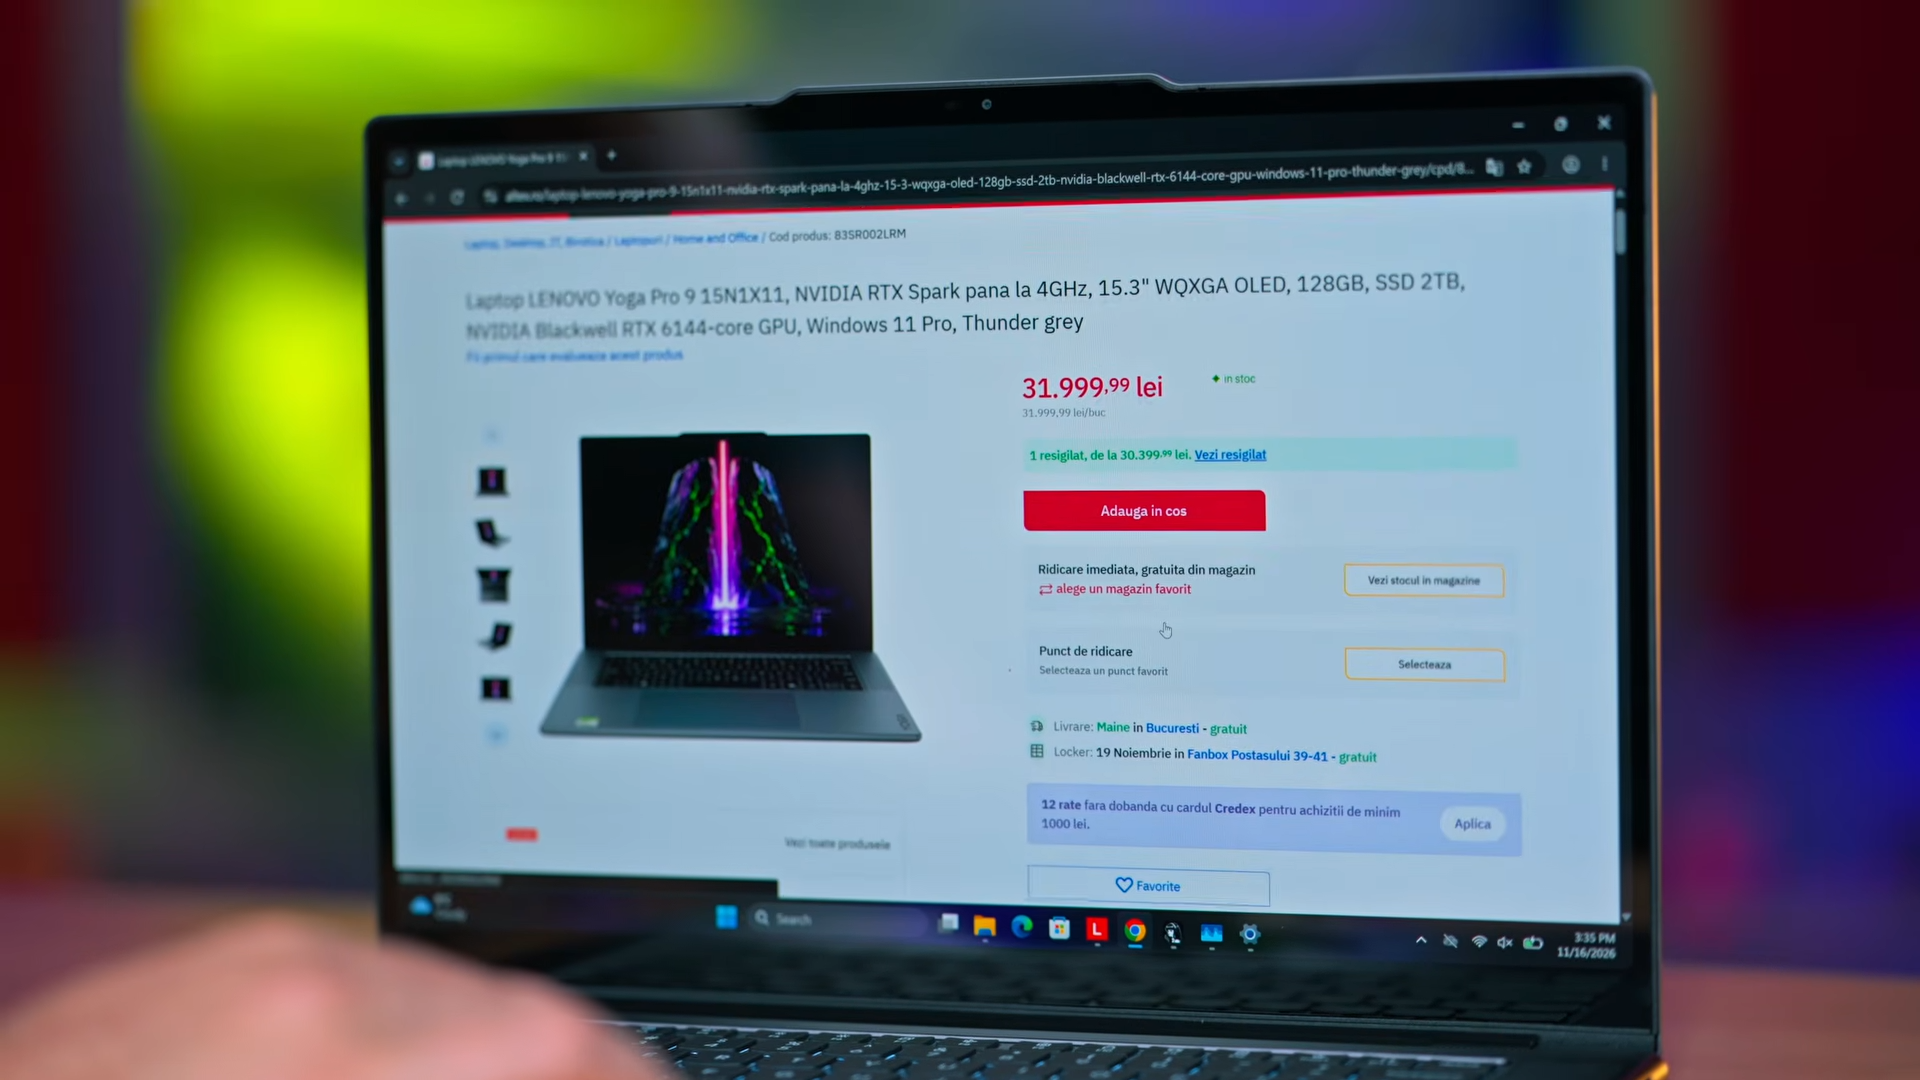
Cât despre implementarea celor de la Lenovo, Yoga Pro 9 Gen 11 este o alternativă foarte solidă: ai o construcție impecabilă din aluminiu, un ecran Tandem OLED absolut superb, chiar dacă eu personal rămân certat cu amprentele de pe touchscreen și nu îi văd sensul, și ai aceeași performanță constantă, atât pe priză, cât și pe baterie. Singurele compromisuri reale rămân bateria ușor mai mică decât mi-ar plăcea și acel buton de Power pus pe lateral, pe care sigur o să-l apeși din greșeală de câteva ori până te obișnuiești cu el.
Până la urmă, ironia rămâne: chiar dacă NVIDIA ne vinde „democratizarea AI-ului” la preț de mașină second-hand, măcar îți pune pe birou o soluție reală prin care să-ți ții datele la tine în curte și să nu mai stai cu morcovul că mâine vine iar o scumpire de tokens.
Pe Yoga Pro 9, versiunea dotată cu RTX Spark, l-am găsit la noi chiar, începând de la 15.500 de lei pentru varianta cu 32GB de memorie unificată. Dacă vrei de 64GB, prețul urcă la 20.000 lei, sau top-of-the-line-ul de 128GB combinat cu 2GB stocare rapidă îți va drena portofelul de circa 32000 lei. Sunt niște scoruri imense cu siguranță, dar din nou țin să menționez faptul că nu poți cumpăra aceste laptopuri și să le folosești ca niște laptopuri normale, pentru că arunci banii pe geam practic. Dacă AI-ul local este în plan pentru voi, atunci da, au sens aceste laptopuri, dar sincer, ai multe de câștigat dacă iei versiunea cea mai potentă.
Autor


